
A rápida construção do maior projeto de data center da história é difícil de acompanhar.
Ao longo de vários meses de conversas com funcionários da OpenAI sobre o projeto Stargate, de um trilhão de dólares (5,3 trilhões de reais), o escopo e a escala do empreendimento aumentaram, tornando-o cada vez mais caro.
"Tanta coisa muda a cada dia", diz o diretor de infraestrutura física, Keith Heyde ,
à DCD em uma entrevista entre as ligações do projeto. "Os objetivos de alto nível continuam os mesmos. Acho que a estratégia de execução para alcançar esses objetivos é dinâmica. Quais parceiros estamos mais interessados, quais estamos tentando garantir que consigamos nos relacionar de forma próxima, está em constante mudança.
"Temos uma demanda computacional excepcional e impressionante que foi solicitada para entrega."
Uma versão dessa matéria apareceu na edição 57 da DCD Magazine, mas foi ampliada com mais entrevistas e detalhes sobre os últimos acordos e anúncios

Uma aposta nas leis de escalada
Stargate começou como um experimento mental. A visão atual sobre o treinamento de grandes modelos de linguagem multimodais (MLLMs) é que quanto mais computação você coloca (junto com cada vez mais dados), melhor será o modelo. Para manter seu ritmo acelerado em software, a OpenAI precisava de uma abordagem igualmente agressiva em relação ao hardware.
"Temos uma convicção muito forte sobre as leis de escalabilidade", diz Chris Malone, chefe de data centers da OpenAI. "Vimos melhorias notáveis no desempenho dos modelos ao longo do tempo, e parece que isso continuará a crescer. Agora, infelizmente, estamos atrapalhando [esse progresso] do lado dos data centers, pois estamos constantemente com falta de capacidade. Um dos nossos principais objetivos é desbloquear isso."
O resultado desse processo de pensamento foi conceituar um data center extremamente grande, com capacidade semelhante à de todo o mercado de data centers da Virgínia – atualmente abrigando a maior coleção mundial de data centers – em 2025.
A OpenAI inicialmente esperava trazer a Microsoft, na época seu fornecedor exclusivo de nuvem e maior apoiador, com o mega data center de 100 bilhões de dólares (534,7 bilhões de reais) e 5 GW. Mas as negociações fracassaram em 2024, com a Microsoft cada vez mais cautelosa quanto ao quanto estava gastando em um rival crescente em um setor ainda não comprovado, e a OpenAI também ficando frustrada com o ritmo relativamente lento do hiperescala.
A eleição de Donald Trump proporcionou uma oportunidade para a Stargate renascer. Encorajada por um presidente que prometia cortar a burocracia e determinada a se manter à frente do rival - e então confidente presidencial - Elon Musk, a OpenAI anunciou que o Stargate seria um projeto de 500 bilhões de dólares (2,6 trilhões de reais) para construir vários grandes campi de data centers nos EUA ao longo de quatro anos.
O resultado final é um Stargate que é claramente diferente da visão original de uma única instalação. Sua amplitude é muito maior, seu escopo mais ambicioso – mas, por enquanto, os data centers individuais são menores. E ainda assim, eles poderiam ser maiores do que qualquer um no mercado atualmente.
Ao mesmo tempo, muito sobre o Stargate permanece pouco definido. Isso é parcialmente intencional, já que a pequena e determinada equipe busca desenvolver a estratégia nos próximos anos. Mas isso também se deve à rapidez dos anúncios, alguns dos quais ainda não recebem fundos completos ou detalhes de contratos, mas estão ligados a momentos políticos – seja a posse de Trump ou sua visita ao Oriente Médio.
Muita especulação tem circulado sobre o valor real do Stargate. Logo após o anúncio, Sam Altman disse aos colegas que OpenAI e SoftBank investiriam 19 bilhões de dólares (101,6 bilhões de reais) no empreendimento, segundo informou o The Information na época. Acredita-se que a Oracle e a MGX, de Abu Dhabi, estejam reunindo um total combinado de 7 bilhões de dólares (37,4 bilhões de reais).
O SoftBank também está em negociações com os mercados de dívida sobre financiamento adicional e investiu na OpenAI (dando a ela dinheiro suficiente para cobrir seu investimento inicial em Stargate). A OpenAI provavelmente buscará arrecadar capital durante a ascensão do Stargate para ajudar a arcar com as crescentes despesas.
Desde então, Altman afirmou que os compromissos do Stargate e OpenAI em nuvem totalizam cerca de 1,4 trilhão de dólares (7,5 trilhões de reais), um nível verdadeiramente sem precedentes de gastos computacionais e significativamente mais do que a empresa pode arcar atualmente.
Projetos individuais do Stargate são, em si mesmos, uma intrincada teia de investimentos. O local mais distante em Abilene, Texas, viu a desenvolvedora Crusoe garantir 15 bilhões de dólares (80 bilhões de reais) em dívida e patrimônio, com fundos gerenciados pela plataforma Real Assets da Blue Owl, junto com a Primary Digital Infrastructure. A maior parte desse financiamento veio do JPMorgan, por meio de dois empréstimos, totalizando 9,6 bilhões de dólares (51,3 bilhões de reais).
A Oracle está atualmente em negociações para gastar até 40 bilhões de dólares (214 bilhões de reais) em 400.000 GPUs Nvidia GB200 para o site, segundo o Financial Times, que depois seriam alugados à OpenAI.
Heyde, que chegou nesta mesma época do ano passado, após quatro anos na Meta, está menos preocupado com os detalhes da contabilidade. "Tem uma espécie de volante de dinheiro com que eu nem me preocupo", ele diz. "Esse é um time relacionado. Tento assumir que o volante de dinheiro vai me dar o que preciso.
"Penso no volante de inércia potência/terra, que é o degrau mais baixo. Então penso no volante de inércia da carcaça. E então penso no volante de inércia de IT."
Começa no Texas
Abilene é o primeiro dos Stargates nos EUA, com a OpenAI basicamente aproveitando um megaprojeto já proposto. O site é, como tudo relacionado a Stargate, uma complexa matrioska de interesses interligados.
Na base está o Lancium Clean Campus, pertencente à Lancium, apoiada pela Blackstone, uma mineradora de criptomoedas que virou desenvolvedora de data centers de IA, que, em outubro, levantou uma dívida de 600 milhões de dólares (3,2 bilhões de reais), liderada pela Santander Corporate & Investment Banking. A empresa arrendou seu local para a Crusoe Energy, outra empresa de investimento em criptomoedas, que então passou a trabalhar em data centers que originalmente seriam alugados à Oracle.
Em 2024, o plano inicial era que a Crusoe construísse 200 MW para a Oracle. O fornecedor de nuvem, que estava ficando cada vez mais atrás dos hiperescalas na era pré-IA generativa, mas, desde então, gastou bilhões em grandes projetos para recuperar o atraso, estava em negociações com Musk para usá-lo em seu empreendimento de IA, xAI. Mas, quando ele desistiu para construir seu próprio site em Memphis, a OpenAI entrou em ação.
Na época, devido ao contrato de exclusividade entre a OpenAI e a Microsoft, o acordo tinha uma camada adicional de complexidade: a Oracle alugaria 200 MW para a Microsoft, que então os forneceria à OpenAI. Com Stargate, DCD entende que o passo adicional foi removido.
Também com o Stargate, as ambições aumentaram: Crusoe agora planeja construir toda a capacidade de 1,2 GW do campus da Lancium. No entanto, em referência à velocidade e ao caos dos primeiros dias de Stargate, a DCD entende que os executivos da Crusoe na conferência da PTC no Havaí, em janeiro, ficaram tão surpresos ao saber que o projeto foi aprovado quanto o resto do mundo.
"Os data halls em Abilene têm cerca de 30 MW", revela Heyde. "Mas aí o local total para nós pode ultrapassar um show se expandirmos ao máximo."
A construção da primeira fase, com dois prédios e mais de 200 MW, começou em junho de 2024 e foi energizada em setembro deste ano.
A segunda fase, composta por mais seis prédios e um gigawatt de capacidade, começou a ser construída em março de 2025 e deve ser energizada em meados de 2026. O prédio foi finalizado em novembro.
Uma subestação foi construída, com outra a caminho – a energia também é fornecida por geradores a gás no local. A Oracle concordou em alugar o local por 15 anos.
"Somos nós e a Oracle", explica Heyde. "E aí você tem suas coisas de tecnologia que vão para a Foxconn, e suas coisas de concha que vão para a Crusoe. E sob a Crusoe, há [o empreiteiro de construção] DPR, e todos os subcontratados como Rosendin no local."
Com os dois primeiros prédios prestes a ficar prontos, Heyde tem feito visitas regulares ao campus. "Minha equipe esteve lá ontem, eu estive lá algumas semanas atrás", ele nos conta. "É mais sobre a prontidão para rack do que sobre a prontidão básica. À medida que lançamos esses racks GB200, esse é o nome do jogo agora."
A cerca de três horas de carro de Abilene, outro projeto da OpenAI está se formando. A Core Scientific está reformando seu data center de mineração de Bitcoin, localizado logo ao norte de Dallas, apresentando-o como um hotspot de data centers de IA.
Esse site é então alugado à CoreWeave, que está trabalhando com a OpenAI. "Nossas interações são com a CoreWeave", diz Heyde. A OpenAI planeja gastar 22,4 bilhões de dólares (119,8 bilhões de reais) em serviços da neocloud, embora não esteja claro se tudo isso passará pelo Stargate.
No mesmo mês em que os primeiros salões em Abilene foram lançados, a OpenAI expandiu significativamente seu contrato com a Oracle para um recorde de 300 bilhões de dólares (1,6 trilhão de reais) em cinco anos, incluindo 4,5 GW de capacidade além do local original.
Desde então, anunciou planos para mais cinco Stargate baseados nos EUA, incluindo um data center de 1 GW em Michigan desenvolvido pela Related Digital e uma grande instalação em Wisconsin da Vantage. Outras estão planejadas no Novo México e no Texas, todas sendo construídas e operadas em parceria com a Oracle.

A instalação do Novo México é respaldada por 3 bilhões de dólares (16 bilhões de reais) da Blue Owl, informa o The Information, enquanto até 18 bilhões de dólares (96,2 bilhões de reais) podem vir em empréstimos liderados pela Sumitomo Mitsui, BNP Paribas, Goldman Sachs e Mitsubishi UFJ Financial. Essa instalação sozinha poderia crescer para 4,5 GW com a construção completa.
A OpenAI também assinou um contrato de nuvem com o Google, que inclui o uso de suas TPUs, e um acordo de nuvem de 38 bilhões de dólares (203 bilhões de reais) por vários anos com a AWS. Quanto à Microsoft, seu fornecedor exclusivo de computação de outrora, a OpenAI, finalizou em outubro sua transição para o setor lucrativo e abandonou o direito de primeira recusa da nuvem da Microsoft.
Ao mesmo tempo, concordou com um contrato Azure de 250 bilhões de dólares (1,34 trilhão de reais) em um período de tempo não divulgado. Em documentos vazados enviados a Ed Zitron, a OpenAI revelou que gastou 5,02 bilhões de dólares (26,8 bilhões de reais) apenas em inferência com a Azure no primeiro semestre de 2025, um aumento em relação aos 3,767 bilhões de dólares (20,1 bilhões de reais) em todo o ano de 2024.
Alguns desses contratos de nuvem podem, então, ser terceirizados para data centers da CoreWeave, o que complica a contabilidade exata da escala do investimento.
Uma camada adicional de complexidade vem dos acordos da OpenAI com fornecedores de silício, que ajudaram a financiar sua ascensão tanto para manter o crescimento do mercado quanto para mantê-la como cliente.
Os suportes de silício
Mais notavelmente, após o uso de TPUs do Google pela OpenAI, a Nvidia anunciou planos de investir até 100 bilhões de dólares (534 bilhões de reais) na empresa, que a OpenAI então investirá em 10 GW de data centers baseados na Nvidia.
Logo depois, a AMD anunciou que forneceria à OpenAI 6GW de computação, em troca de permitir que a empresa comprasse 160 milhões de ações (10% da AMD) a apenas um centavo cada.
Isso foi seguido pela promessa da Broadcom de implantar 10 GW de seus chips de IA personalizados para a OpenAI até 2029. As empresas estão codesenvolvendo aceleradores de IA, com os esforços da OpenAI liderados pelo ex-líder da TPU, Richard Ho.
Se tudo isso acontecer, significará que a OpenAI terá que operar uma variedade muito maior de tipos de computação do que sua frota atual, composta principalmente por Nvidia Hopper e Blackwell.

"Eu só vejo o número de tipos de chips muito maior", diz Joel Morris, chefe de planejamento computacional da OpenAI, à DCD. "Então, esse vai ser um espaço interessante para resolver.
"Podemos perceber que, para algumas cargas de trabalho, Blackwells são realmente bons, e queremos continuar a escalar nos Blackwells, enquanto, para outras cargas, talvez tenhamos que encontrar outro caminho e encontrar uma forma de otimizar."
O trabalho de Morris é garantir que haja computação suficiente, do tipo certo e no local certo, para as cargas de trabalho de hoje e de amanhã. "Se o GPT funciona perfeitamente para você, eu sou o mocinho. Se não, eu sou o vilão", ele brinca.
"Quando se trata de previsão por IA, você tem essa fila de Hoppers, Blackwells e diferentes tipos de SKUs disponíveis para fornecer inferência. E aí você tem as cargas de trabalho: uma carga de trabalho multimodal é muito diferente de uma carga de trabalho comum no chat. Um pode precisar de mais memória, e o outro pode não.
"Depois, há requisitos regionais. Talvez seja necessário levar em conta a confiabilidade, e então o desempenho de um Blackwell em diferentes produtos também pode não ser o mesmo. Então é um problema multidimensional de alocação e otimização, do qual você vai aprendendo constantemente. Às vezes, é preciso decidir atender a Blackwell para um tipo muito específico de demanda e, depois, encontrar uma forma de torná-la mais eficiente para o outro tipo de produto."
Em alguns casos, modelos de IA simplesmente não rodam sem computação suficiente. "Alguns têm um número mínimo de nós de GPU implantados para rodar, então continuamos experimentando o que está chegando, o que está mudando, para continuar gerenciando isso em meio à forma como planejamos implantar os data centers."
A equipe de Morris está fora do esforço Stargate, mas alimenta-o. "Definitivamente existe um ciclo de retroalimentação que circula constantemente, dizendo: 'olha, a demanda parece ser assim', ou 'é assim que se manifesta a preferência do consumidor, e também como é a evolução do modelo'."
Da mesma forma, a equipe Stargate precisa manter comunicação próxima com os planejadores de computação, bem como com a equipe principal de pesquisa. "Uma parte muito divertida do nosso trabalho durante o verão tem sido trabalhar com as equipes de pesquisa e de software para decompor suas necessidades de carga de trabalho em regras físicas, no mínimo", diz Heyde.
"Então, podemos pensar em estratégias de implantação mais rápidas para isso. Esse item de latência, que é discutido, está diretamente correlacionado ao comprimento da rede, que está diretamente ligado à forma como pensamos sobre a pegada do nosso edifício e do nosso campus."
O Stargate torna-se global
Fora dos EUA, o Stargate está avançando com vários projetos. Nos Emirados Árabes Unidos, a OpenAI recorreu à Oracle, Cisco, Nvidia e SoftBank para desenvolver uma funcionalidade que suporte até 5 GW em um projeto liderado pela G42.
O presidente e acionista controlador do G42, Tahnoun bin Zayed Al Nahyan, é irmão do presidente dos Emirados Árabes Unidos. Tahnoun também é conselheiro de segurança nacional do país e presidente da MGX, apoiadora do Stargate.
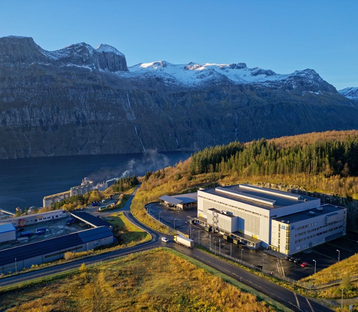
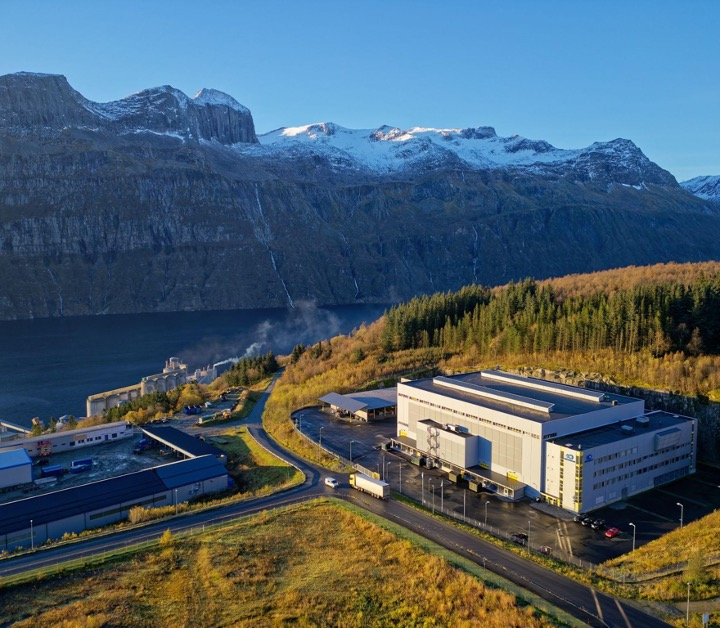
Na Europa, a Nscale e a Aker estão desenvolvendo um projeto Stargate Norway com cerca de 100.000 GPUs, enquanto a Nscale também está implantando uma GPU Stargate Developermen menor de 8k no Reino Unido, potencialmente espalhada por vários locais.
Menos claros são os demais locais que a OpenAI está avaliando. Uma instalação de 500 MW foi prometida para a Argentina, mas o projeto não parece ter saído da fase de carta de intenção. Da mesma forma, a empresa afirmou que está considerando desenvolver no Canadá.
A OpenAI assinou um MoU com a SK Telecom para desenvolver um data center de IA na região sudoeste da Coreia do Sul, enquanto executivos da OpenAI foram vistos visitando a Ásia para explorar potenciais locais na Índia, no Japão e outros lugares.
Muitas das empresas envolvidas nesses projetos são profundamente interconectadas – com Oracle, SoftBank e MGX (por meio do G42) financiando o empreendimento como um todo, além de algumas instalações individuais.
A Nvidia, ao mesmo tempo em que investe na OpenAI, também investiu em muitas das neoclouds que tornam possível a rápida expansão de Stargate. A empresa já apoiou tanto a CoreWeave quanto a Nscale, para citar apenas alguns de seu vasto portfólio, e acredita-se que esteja considerando apoiar os empréstimos para data centers da OpenAI. Não está claro quanto dos investimentos anunciados anteriormente pela Nvidia será incorporado ao acordo de 100 bilhões de dólares/10 GW.
"Não conseguiríamos chegar onde estamos hoje sem as parcerias em todos esses espaços com os parceiros que existem hoje, incluindo a Oracle e muitos outros que nos ajudaram a chegar até aqui", diz Heyde.
"Acho que entender quais data centers precisamos desenvolver totalmente internamente e quais somos parceiros é a arte central por trás da ciência aqui."
O tamanho perfeito
Com a OpenAI plantando sua bandeira em Abilene como o primeiro de seus Stargates, outros desenvolvedores migraram para a região para adquirir terras e buscar energia, na esperança de experimentar o efeito de rede observado nos booms pré-gerativos de data centers de IA.
"Acho que, sempre que você tem um agrupamento de habilidades em determinado conjunto de uma área, você cria um centro de excelência", diz Heyde, mas admite que não tem certeza se os mesmos efeitos de rede serão observados.
"Do ponto de vista da vantagem tecnológica, não achamos necessariamente que isso seja super vantajoso. Porque, no fim das contas, a distância da sua rede back-end é como o tamanho do cluster. Então há um argumento de 'não importa se você tem 15 anos ou está a 600 [quilômetros] de distância.'"
Esse limite de rede pesa muito na mente de Heyde. "O ponto ideal para um local de treinamento é entre 1 GW e 2 GW", ele diz. "Acima de 2 GW, as coisas começam a ficar meio bobas porque as distâncias de rede de back-end são um pouco longas demais. Eles estão longe demais para fazer o que você precisa fazer."
Nesse ponto, alguns racks ficam tão distantes entre si que o data center poderia muito bem estar espalhado.
"Mesmo que você tenha o terreno perfeito, a parte mais complicada do design é a distância de networking", ele diz. "Se você for construir um data center de um andar, em certo nível, a distância de rede fica grande demais para ter um cluster enorme ali."
Claro que alguém poderia migrar para um apartamento de vários andares para apertar ainda mais as prateleiras. "O desafio com o multi-andar é que a) Existe uma operação que vem com isso; Mas b) também há um pouco de variabilidade logística sobre quando começarmos a entrar nessas estantes realmente grandes no futuro", ele diz. "Se estamos falando de racks que pesam entre 6.000 e 7.000 libras (por volta de 3.175 quilos), você começa a entrar em projetos de construção bem estranhos."

Essa abordagem de múltiplos andares foi anunciada pela Microsoft, que lançou seu data center em Atlanta, baseado no novo design Fairwater. A empresa afirmou explicitamente que construiu o local como um prédio de dois andares para reduzir a distância entre os racks. Frustrantemente, porém, a empresa recusou múltiplos pedidos do DCD para divulgar o tamanho real do data center.
Embora um campus mega data center de 5 GW possa não fazer sentido, vários campi de 1-2 GW ainda podem funcionar juntos. "O que descobrimos é que as limitações de distância consideradas há cerca de um ano relaxaram um pouco, com base nas abordagens que estamos usando para treinamento em grande escala e em múltiplos campi.
"Então não estamos necessariamente olhando para agrupamentos apertados associados à latência. Na verdade, estamos olhando para clusters posicionados, provavelmente mais em nível nacional, que podem coordenar, desde que haja largura de banda suficiente."
O Google já revelou publicamente que treinou o Gemini 1 Ultra em múltiplos clusters de data centers, enquanto se acredita que a OpenAI esteja desenvolvendo métodos de treinamento síncronos e assíncronos para seus modelos futuros. Com a Fairwater, a Microsoft disse que planeja conectar todos os seus próximos clusters por meio de uma Rede de Área Ampla com IA.
Enquanto alguns hiperescaladores valorizam conexões diretas de fibra entre campi distintos, Heyde diz que a empresa não está considerando isso no momento. "Tivemos algumas conversas internas; tenho que garantir que consigamos alguns campi de data center primeiro."
Incluindo o Texas, a OpenAI está considerando desenvolver até dez projetos nos EUA, e, em fevereiro, a empresa disse que estava considerando 16 estados. "Sinceramente, acho que estamos um pouco acima disso agora", diz Heyde.
Quando pedimos a Heyde que detalhasse o que ele procura nesses sites durante uma palestra principal no evento DCD>New York desse ano, ele nos disse: "Enquanto fazemos esses treinamentos em vários campi, o acesso à fibra de grande largura de banda é bastante crítico."
Energizando o Stargate
Quanto à energia, a OpenAI está avaliando tanto "a prontidão da subestação quanto o lado associado do data center, mas também a potência total desse local", diz Heyde.
Ele continua: "Acho que uma das coisas interessantes que vimos no processo de RFP é que as pessoas enquadram sua disponibilidade de energia de forma muito diferente, dependendo de se falam disso sob a perspectiva de uma concessionária, fornecedora de energia, operadora de data center ou construtora de data center. O horizonte temporal que as pessoas atribuem a esse energia varia bastante conforme suposições embutidas."
Malone concorda, observando que a empresa está "pensando em diferentes formas de entregar a energia de que precisamos" com projetos de trabalho "mas também, no horizonte de longo prazo, soluções de carga base livres de carbono, como SMRs e fusão, que precisam fazer parte da nossa solução de longo prazo."
Mesmo depois de encontrar energia da rede, uma preocupação para as concessionárias tem sido as grandes oscilações de energia que um único aglomerado coordenado pode provocar. A empresa, junto com Nvidia e Microsoft, publicou, em agosto deste ano, o artigo 'Power Stabilization for AI Training Datacenters', com o objetivo de analisar como minimizar o problema.
"Fundamentalmente, não podemos sobrecarregar nossa rede de utilidades com algo assim", diz Malone. "Conectar-se à rede é extremamente benéfico para nós, por isso temos vários métodos para lidar com essas oscilações de poder. Seja no gerenciamento de chips, em soluções de gerenciamento de energia ou no uso de nobreak para absorver essas oscilações de energia.
"Com o tempo, vamos ver cada vez mais desenvolvimentos na área de capacitores mais próximos dessa carga de chip, então podemos basicamente usar uma bateria de reação muito rápida para absorver essas oscilações, em vez de gerenciá-las no chip. O objetivo é liberar o máximo de desempenho possível do sistema. Mover essa solução de isolamento para os capacitores ou para o nobreak é realmente o que precisamos fazer."
A rival xAI resolveu parte do problema com seu site Colossus ao impulsionar tudo por meio de uma grande implantação de Megapacks Tesla, provavelmente mais acessível por conta do controle de Musk sobre ambos os negócios. "Essa é uma abordagem super interessante para o problema", diz Malone sobre a medida.
"Acho que ainda não há uma resposta definitiva sobre qual é a solução certa, e provavelmente depende dos atributos da carga de trabalho e da escala. Mas acho que o armazenamento mais próximo possível do hardware é uma abordagem extremamente útil para o problema. No período intermediário, temos ferramentas no silício para ajudar a gerenciar isso."
A disponibilidade de energia também tem sido um tema polêmico para as comunidades locais, com relatos conflitantes sobre o impacto das instalações de IA nos preços da eletricidade, o que ajudou a gerar uma onda de sentimento anti-data center e atrapalhou alguns projetos.
No caso do Stargate Wisconsin, codinome Lighthouse, o desenvolvedor Vantage prometeu implantar novos sistemas líquidos de energia solar, eólica e baterias, além de fornecer energia excedente aos clientes de Wisconsin. Também afirmou que garantiria 100% do investimento exigido pela concessionária em infraestrutura de energia.
Da mesma forma, para o projeto de Michigan, conhecido como The Barn, a Related Digital financiará um novo investimento no armazenamento de baterias.
A energia, no entanto, é apenas um dos desafios que projetos dessa escala enfrentam.
"Se estamos construindo a muitos gigawatts por ano, quais são os gargalos que surgem logo após a energia?" Malone pergunta. "Certamente, há trabalho artesanal. Como aplicamos princípios de design para melhorar a eficiência no setor da construção? Sabemos que há um número finito de recursos humanos no campo, nesse local [Abilene], por exemplo, há muita gente, certo? Então, como realmente escalamos o componente humano da construção também?"
Depois há a terra, mas "o legal para nós é que nossa área física é um pouco menor com base na densificação", diz Heyde. "E então, a última coisa que eu diria ser realmente crítica é que queremos ir a lugares onde as pessoas queiram que estejamos."
Um novo tipo de data center
Quando chegar a esses lugares, pode ser feito por meio de parceiros – como a Oracle, Crusoe, CoreWeave ou Core Scientific. Ou poderia construir seus próprios sites por completo.
"O Stargate e OpenAI têm ambos um interesse em autoconstrução, sim", diz Heyde.

"Definitivamente, será um design inovador, comparativamente. O design de Abilene estava realmente ancorado em outra coisa, e depois foi reaproveitado para a abordagem GB200. Estamos trabalhando nisso, e uma abordagem de autoconstrução será ancorada em como seguiríamos um grande regime de treinamento no futuro. Existem coisas empolgantes que você pode fazer do ponto de vista da redundância e da tolerância ao risco que provavelmente não faria em um site na nuvem."
Em outra conversa, ele nos diz: "Estamos projetando com base em uma perspectiva de três nove, em vez de uma perspectiva de cinco nove." Ou seja, construir com uma expectativa de 99,9% de uptime em vez de 99,99%. "Isso nos dá muita flexibilidade de design, mas também certos trade-offs que podemos fazer na pilha de energia, assim como nos trade-offs de seleção de locais.
"Como nosso design é relativamente único, e porque está centrado nessas cargas de treino de três a nove pessoas, temos um pouco de flexibilidade para jogar de maneiras diferentes com jogadores diferentes, algo que acho que você não vê em um design de referência mais estabelecido que acaba sendo superado."
Aqui, Heyde está falando sobre centros de treinamento, ou como ele gosta de chamá-los, "clusters que facilitam pesquisa", principalmente construídos para "impulsionar nossas capacidades no lado dos modelos para frente." Isso, ele diz, é diferente do binário treinamento versus inferência, que originalmente era visto como as duas cargas de trabalho de IA distintas do futuro.
"Os meios e mecanismos pelos quais avançamos nossos modelos evoluíram à medida que a indústria seguia rumos distintos. Então, neste ponto, a partir dos modelos de raciocínio, conseguimos avançar as capacidades do nosso software usando coisas que são um pouco diferentes do treinamento clássico", com os modelos sempre em algum tipo de treinamento e inferência.
Ao mesmo tempo, porém, o Stargate planeja ter uma computação mais focada em inferência, uma mudança em relação à visão inicial de um único mega-cluster de treinamento. Essa inferência ocorre em conjunto com um relacionamento extenso e contínuo com o Microsoft Azure.
Algumas das inferências podem se manifestar em clusters de treinamento envelhecidos nos próximos anos. À medida que as GPUs Nvidia de ponta envelhecem, sugerimos que elas passem a atender à demanda dos usuários. "Acho que essa não é uma má abordagem", diz Heyde. "Acho que isso tem mérito."
A empresa também está buscando construir clusters específicos de inferência. "Poderíamos fazer uma inferência e um caso de uso para o consumidor que é bem menor [do que os campi da 1 GW]", diz ele. "Na verdade, isso está no mercado agora, mas minha equipe está analisando alguns sites menores para ver como implantaríamos – não quero chamá-los de microsites; eles ainda são bem grandes – um site de inferência ou voltado para o cliente rapidamente."
Ele acrescenta: "Provavelmente ainda é dinâmico demais para dizer com certeza [qual será o tamanho deles], mas posso dizer que, à medida que nos projetamos para o futuro, essa parte da nossa demanda definitivamente aumenta. Essa é a parte voltada ao cliente da nossa demanda. E não é só por aumentar o engajamento do cliente, mas também porque cada vez mais cargas de trabalho conseguem migrar para esses sites mais eficientes – eles não são realmente sites Edge, mas são mais como regimes de sites Edge. Você só tem mais demanda, que é canalizada para lá."
Alguns clientes exigem computação dedicada com acordos de nível de serviço (SLAs) dedicados. "Temos que encontrar o SLA. Na verdade, temos metas de latência muito rígidas", diz Morris, da OpenAI. "Nunca queremos que o consumidor, seja um usuário individual ou uma empresa, tenha problemas de latência, então sempre tentamos equilibrar isso."
Dependendo do modelo, no entanto, as demandas de latência geralmente são "mais flexíveis do que as pessoas pensam", diz Heyde.
Conversamos na noite após a OpenAI revelar que está prestes a comprar a Io, a empresa liderada pelo guru do design da Apple, Jony Ive, com o plano de desenvolver produtos para consumidores. A empresa ainda não revelou detalhes concretos sobre os dispositivos, mas um vídeo de anúncio faz referência a um sistema sempre ligado e sempre ouvindo para permitir a participação do ChatGPT a qualquer momento.
Tal sistema, caso se torne popular, exigiria ainda mais computação e armazenamento.
Heyde não está envolvido no projeto, mas diz sobre o lado do data center: "Os números que Sam [Altman, CEO da OpenAI] compartilhou conosco mais cedo hoje, foram algo tipo 'adicione um zero extra'. Parece que nunca tive uma quebra na demanda, nem mesmo quando a DeepSeek realmente abalou o mercado."
Incerteza vs inevitabilidade
Outro choque de mercado foi a guerra do presidente dos EUA contra a economia global, com tarifas súbitas e drásticas aplicadas praticamente ao mundo inteiro (as tarifas são pagas pelo importador, não pelo exportador). Algumas dessas tarifas foram retiradas, outras foram aumentadas. No momento em que escrevo, a situação atual das tarifas é muito flexível para que valha a pena especificar as porcentagens individuais.
Analistas do TD Cowen alertaram que as tarifas podem adicionar custos de 5% a 15% à construção de data centers Stargate, um custo enorme considerando a escala da joint venture. "Essa é interessante", diz Heyde sobre as tarifas.
"Muitas das decisões de sourcing que eu tomava já eram baseadas na América do Norte. Então, o bom foi que eu não vi grandes problemas tarifários por causa disso, [mas] vi outros projetos que estávamos analisando que tiveram grandes interrupções. A volatilidade é metade do desafio."
Por enquanto, o desenvolvimento continua sem interrupções. A velocidade continua sendo a maior prioridade, com a OpenAI travada em uma corrida por um prêmio que acredita que supera facilmente qualquer aumento momentâneo de custo.
"De certa forma, isso nos leva a um pouco de curto prazo em nossas decisões", admite Heyde. "Queremos realmente desbloquear o treinamento. Na verdade, acho que estamos bem com um pouco de ineficiência de custos – quero dizer isso com delicadeza – para permitir bons momentos de treinamento."
O desejo de rapidez, junto com uma grande carteira, traz seus próprios desafios, e a empresa é inundada com ofertas de desenvolvimento, a maioria das quais é inadequada.
"Imagine que você está em um restaurante, e há tantas opções no cardápio, e é hora de garantirmos que escolhemos as dez opções que queremos, não as 100 que temos à disposição", diz Heyde.
Dessas dez opções, "estamos tentando pensar em dois ciclos no design do nosso data center, você não tem apenas um e pronto", diz Heyde.
"É difícil quando falamos dessas densidades de potência e também é difícil para mim não olhar para o terreno e pensar: 'racks vão ser nosso formato em oito anos?' O formato todo do rack pode mudar devido às densidades de potência de que estamos falando."
Ele diz que consegue ver os data centers do futuro contendo o que é "efetivamente líquido, reconfigurável, computação." Com isso, Heyde não se refere a sistemas de resfriamento por imersão, mas sim a "condutos líquidos dinâmicos que podem ser reconfigurados como parte da infraestrutura de computação do data center."
Da mesma forma, Malone tem visões radicalmente diferentes de data centers para o futuro.
"Todos nós falamos de computação em escala de gigawatts agora, como se fosse apenas uma coisa", ele diz. "Mas é realmente sem precedentes. Estamos pensando em como escalamos de forma diferente. Se você olhar para a forma como construímos data centers há 15 anos, quando 30 MW era uma quantidade enorme, muitas vezes o que fizemos para construir um data center de 300 MW foi fazer dez vezes mais da mesma coisa."
Para a próxima ampliação, a OpenAI não quer apenas multiplicar por dez novamente. "Como podemos pensar em componentes maiores, mais integração, práticas mais centradas na manufatura para realmente entregar em uma escala tão incrível?"
Ecoando os comentários de Heyde, ele acrescenta: "Estamos pensando no tamanho dos componentes que colocamos nesses sistemas e em como isso precisa mudar, e pensando nisso até o rack.
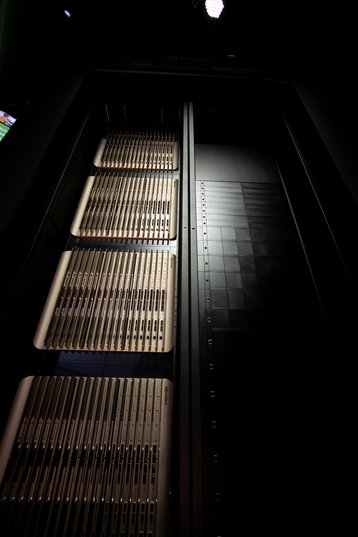
"Um gabinete de 19 polegadas, existe há muitos, muitos anos, e não acho que precise ser assim, certo? Se estamos pensando em velocidade, se estamos pensando em uma vida útil de um cluster, medida em anos de um dígito, por que não entregar a capacidade de forma que permita mudanças rápidas ou implantação rápida, com algum sacrifício que talvez atualmente não consigamos compreender?"
Outro problema com as abordagens atuais é que "data centers são projetados em torno de restrições humanas", diz Malone. "Então, podemos pensar diferente sobre temperatura, altura e peso? Estamos falando de racks de um megawatt em algum futuro hipotético, não tão distante; esses são cenários extremamente diferentes dos racks de 10 kW que eram predominantes há dois anos. Realmente precisamos abordar todo esse ecossistema de forma diferente, do lado tecnológico ao lado humano."
Seja qual for a aparência do novo rack, a OpenAI planeja compartilhar seus designs, diz Malone. "Acho que cabe a nós, como indústria, avançar com isso para que todos possamos nos beneficiar dessas mudanças. Não acho que haja grande valor em manter nossa infraestrutura em segredo, como um formato de rack secreto – podemos aproveitar a escala em toda a indústria. Não quero ser muito exigente com algumas dessas soluções, que se beneficiariam se mais pessoas as adotassem."
Heyde acrescenta: "Isso era coisa de ficção científica há cinco anos, mas não tão fora do que estamos falando agora."
Se seu próprio esforço de ficção científica tiver sucesso, Heyde terá sido parcialmente responsável por colocar em operação os maiores clusters de computação que o mundo já viu, potencialmente suportando inteligências sobre-humanas – ou, pelo menos, simulacros de inteligência.
"A missão é criar uma IA que resolva os problemas mais difíceis do mundo e, para mim, essa é uma missão muito empolgante. Tendo passado muitos anos da minha vida buscando um doutorado e expandindo a ciência, realmente tentar criar algo que possa resolver os problemas mais difíceis do mundo é algo bastante empolgante", diz ele.
Perguntamos a Heyde como ele usaria tal AGI se pudesse colocá-la em um desafio central com Stargate: "O que é difícil para mim entender é a sequência de ações a serem tomadas para desbloquear a melhor abordagem. Não é tanto a sequência do ponto de vista do mapeamento de oferta e demanda, mas sim quais capacidades e sinais de mercado preciso desbloquear para alcançar o melhor estado objetivo em diferentes momentos de treinamento.
"De certa forma, você desbloqueia algo fazendo um Abilene; de outras formas, você desbloqueia algo fazendo uma autoconstrução em algum lugar. De outras formas, você desbloqueia algo ao trabalhar com outro parceiro. Essas capacidades e os sinais de mercado simulados levam você a diferentes estados finais. Por causa do espaço variável e do espaço de oportunidades, é meio difícil conceber qual é a solução global perfeita, embora eu veja, localmente, muitas soluções positivas."




Comments