

Durante boa parte da minha carreira, a conectividade e cabeamento eram as últimas linhas do projeto. Primeiro vinham energia, refrigeração e servidores; depois, quase como formalidade, alguém fechava a lista de patch cords e trunks. Era um item importante, mas previsível. Quem já participou de uma concorrência de DC sabe do que estou falando: o cabo entrava no fim e, muitas vezes, saía na negociação de preço.
Isso acabou! Nos DCs construídos para inteligência artificial, a fibra passou a fazer parte da arquitetura da rede. Não é exagero. É consequência direta de como as GPUs conversam entre si, e a nova geração de plataformas da NVIDIA, a Vera Rubin, deixa isso mais evidente do que nunca.
O tráfego mudou de direção
No data center corporativo que conhecemos bem, a maior parte do tráfego vai e volta entre o usuário e o servidor. Cada aplicação tem seu ritmo, os picos se espalham ao longo do dia e a rede pode ser dimensionada com uma boa dose de compartilhamento. O cabeamento estruturado nasceu para esse mundo: ligações ponto a ponto, organizadas, fáceis de documentar e de mudar.
Um cluster de IA funciona de outro jeito. Milhares de GPUs trabalham no mesmo problema ao mesmo tempo e, a cada etapa do treinamento, precisam trocar resultados entre si antes de seguir adiante. É um tráfego lateral, intenso e sincronizado. E existe um detalhe cruel: o trabalho inteiro anda na velocidade do caminho mais lento. Uma porta congestionada ou um link com perda acima do previsto não atrasa uma aplicação, atrasa o cluster todo. Em infraestruturas que custam centenas de milhões de dólares, minutos de GPU parada têm preço.
É por isso que a conversa sobre conectividade em IA começa pela topologia da rede, e não pelo catálogo de cabos.
Vera Rubin, planos e uma ideia antiga com nova importância
O rack Vera Rubin NVL72 reúne 72 GPUs, e cada uma delas precisa de 1,6 terabit por segundo de conexão com o restante do cluster. É o dobro da geração anterior, a GB300. Ligar essa banda inteira em um único switch seria o caminho óbvio, e também o mais caro quando o cluster cresce: passados alguns milhares de GPUs, seria preciso acrescentar uma terceira camada de switches, com mais equipamentos, mais óptica, mais energia e mais latência.
A NVIDIA resolveu de outra forma. A banda de cada GPU é dividida em oito fatias de 200G, e cada fatia segue para um switch diferente. Cada conjunto desses switches forma uma rede independente, que o mercado chama de plano. São oito redes paralelas atendendo as mesmas GPUs. Com isso, uma arquitetura de apenas duas camadas consegue alcançar dezenas de milhares de GPUs. E, se um plano tiver problema, a GPU perde um oitavo da banda, não a conexão.
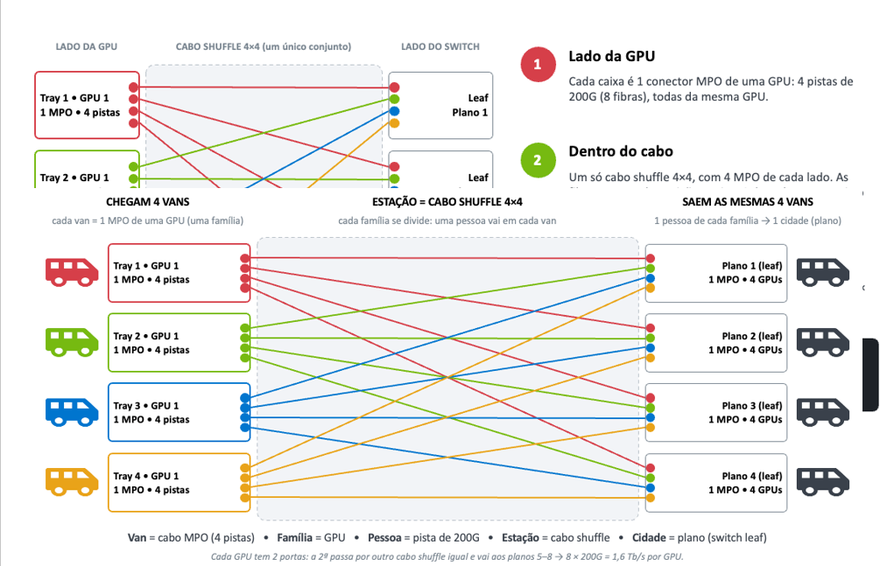
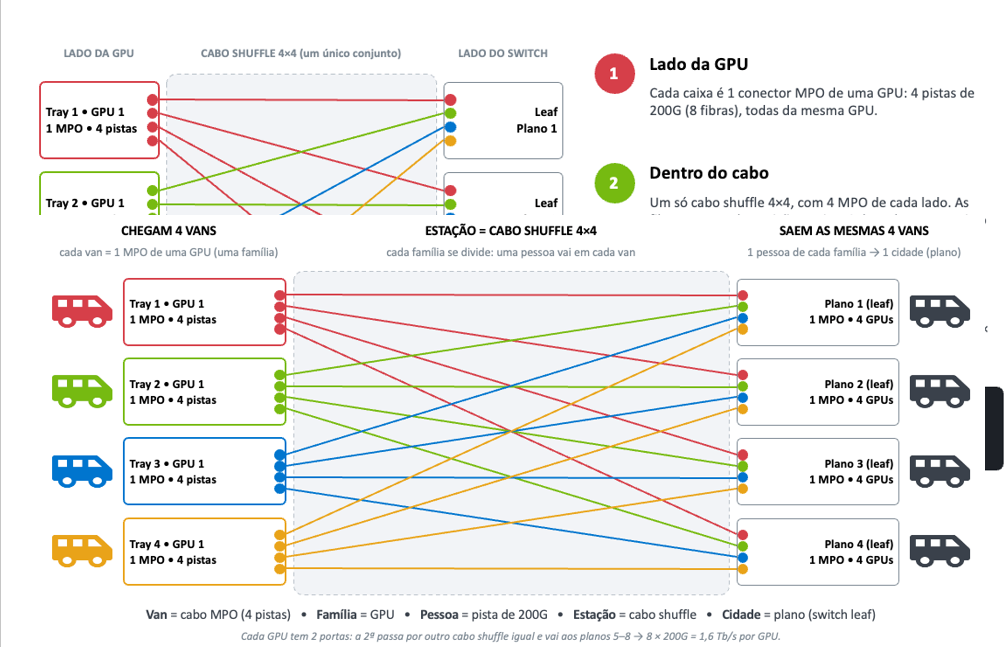
Falta a parte física: como garantir que cada fatia chegue ao switch certo? A resposta é o fiber shuffle. Gosto de explicar com uma imagem simples. Imagine quatro vans chegando a uma estação, cada uma com quatro pessoas da mesma família. Na estação, cada família se divide de forma organizada e as quatro vans partem levando um integrante de cada família, cada van para uma cidade diferente. As vans são os conectores, as famílias são as GPUs, as pessoas são as pistas de dados e as cidades são os planos. A estação é o cabo, que faz essa redistribuição dentro dele, sem eletrônica e sem configuração.
Na GB300, esse embaralhamento é feito em grupos de dois (o chamado 2×2). Na Vera Rubin, em grupos de quatro (4×4). A lógica é a mesma; o baralho é que ficou maior.
Vale uma ressalva honesta, que ouvi de um engenheiro de rede numa conversa recente com um grande fabricante de servidores: em clusters pequenos, o shuffle não reduz a quantidade de switches. O ganho ali é distribuir o tráfego e evitar que poucos fluxos gigantes congestionem uma porta. A economia de equipamentos aparece quando o cluster cresce e a terceira camada deixa de ser necessária. Em todos os casos, uma parte da complexidade da rede sai dos equipamentos ativos e passa para a camada passiva. Ou seja, para a Fibra ótica, o Trunk-Cable.
O que muda no cabeamento?
Quando coloco lado a lado um projeto tradicional e um projeto de IA, as diferenças aparecem em quase todos os itens que antes considerávamos resolvidos.
A lógica da ligação. No cabeamento estruturado, um conector de um lado corresponde a um conector do outro. No cluster de IA, um único conector que chega ao switch carrega pistas de quatro GPUs diferentes. O mapeamento deixa de ser um para um e passa a ser muitos para muitos. Um erro de posição não derruba um link: desalinha um plano inteiro.
Densidade: Cada servidor Vera Rubin, com suas quatro GPUs, sai com oito conectores multifibra só para a rede de GPUs. Um rack completo soma 144. Multiplique por dezenas de racks e o espaço em painel vira um problema real. É por isso que conectores muito pequenos, como o MMC-16, que cabe cerca de três vezes mais fibras por unidade de rack que o MPO tradicional, saíram do laboratório e entraram na arquitetura de referência, podemos colocar em uma única unidade rack 1U até 3.456 FO.
Margem de perda: Nas redes corporativas, quase sempre sobrava orçamento óptico. A 200G por pista, cada conexão a mais e cada conector mal limpo consomem uma margem que já é pequena. Limpeza, qualidade de terminação e número de pontos de conexão passam a ser decisões de desempenho, não de acabamento.
Onde o cabo passa: Com refrigeração líquida, a traseira do rack fica tomada por manifolds e PDUs. A fibra sobe: painéis instalados acima do rack, em bandejas, com energia e líquido por baixo e conectividade por cima.
A ordem da obra: Antes, o cabeamento era instalado depois dos equipamentos. Hoje, fabricantes como a Dell entregam racks completos, montados e testados na fábrica. Se o rack chega pronto para ser posicionado e ligado, a infraestrutura de fibra precisa estar instalada e certificada antes, à espera dele. Quem não se planejar para isso transforma o cabeamento no caminho crítico do projeto.
Onde embaralhar
Uma pergunta que tenho ouvido com frequência de integradores é onde, afinal, o shuffle deve ser feito. Não existe uma resposta única, e desconfio de quem oferece uma.
O embaralhamento pode acontecer num cabo curto, entre o painel no topo do rack e as GPUs. É a opção mais simples e de menor custo de material, mas exige mais mão de obra, porque são muitas peças para lançar e conectar. Pode acontecer dentro de módulos no painel, o que dá flexibilidade para misturar as conexões de acordo com o projeto, ao custo de mais pontos de conexão no caminho. Ou pode vir pronto dentro de truncks pré-terminados de alta contagem de fibras, montados, limpos e testados em fábrica, que reduzem peças, perda e tempo de instalação, mas pedem um projeto bem fechado desde o início.
A escolha depende da escala, do prazo e de quem vai instalar. Um piloto com poucos racks não tem as mesmas necessidades de uma fábrica de IA com centenas deles. O importante é que essa decisão seja tomada na fase de projeto, junto com a definição da rede, e não descoberta na obra.
O que isso exige de quem projeta e instala
A NVIDIA passou a tratar a fábrica de IA como um sistema único, do chip à rede elétrica. É a proposta da plataforma DSX, que inclui projetos de referência validados para cada geração de GPU. Para quem trabalha com infraestrutura, a mensagem é clara: os componentes passivos também precisam conversar com esse projeto. Na Siemon, temos trabalhado próximos à NVIDIA justamente nesse alinhamento, com painéis, conectores e troncos desenvolvidos a partir das arquiteturas de referência, e com testes de campo em clusters Vera Rubin em andamento.
Na América Latina, esse movimento chega com algumas particularidades. Os primeiros projetos de IA em escala já estão na mesa de operadores e provedores de nuvem da região, e muitas vezes com prazos mais curtos do que os que vemos nos Estados Unidos. Ao mesmo tempo, a mão de obra especializada em fibra de alta densidade ainda é escassa. Isso pesa a favor de soluções pré-terminadas e testadas em fábrica, que transferem a parte mais delicada do trabalho para um ambiente controlado e reduzem a dependência de terminação em campo.
Pela minha experiência, quatro cuidados fazem diferença:
- Trazer o projeto de cabeamento para a mesma mesa da arquitetura de rede, desde o primeiro desenho.
- Planejar pensando em múltiplos planos mesmo quando o cluster começa pequeno, porque refazer a camada física depois custa caro.
- Exigir relatórios de teste e de limpeza de cada conjunto, e não apenas a certificação do canal no final.
- Reservar desde cedo o espaço acima dos racks para painéis e bandejas, antes que a refrigeração líquida ocupe tudo.
A conectividade como parte da decisão
A cada nova geração de GPU, a discussão pública se concentra em teraflops, memória e consumo de energia. É natural. Mas quem está no chão do data center sabe que o desempenho prometido no papel só aparece quando cada pista de dados chega ao lugar certo, com a perda certa, no tempo certo.
O shuffle simboliza bem essa mudança. Uma parte da inteligência da rede, que antes vivia só nos switches, agora também está na forma como as fibras são organizadas. Isso não torna o cabeamento mais complicado para quem o planeja com antecedência. Mas cobra caro de quem o deixa para o fim.
A conectividade deixou de ser o último item da lista. Nos projetos de IA, ela precisa estar entre os primeiros.

Comentários