

Nenhuma tecnologia dominou mais as manchetes recentes do que a IA, principalmente grandes modelos de linguagem (LLMs), como o ChatGPT. Um dos facilitadores críticos dos LLMs são poderosos clusters de GPUs, que podem treinar modelos de IA para classificar e prever novos conteúdos com um grau razoável de precisão.
O treinamento é o processo pelo qual um modelo de IA aprende a responder corretamente às consultas dos usuários. A inferência é o processo pelo qual um modelo de IA treinado responde às consultas dos usuários.
Esses grandes clusters de GPUs são caros para adquirir, implementar e operar, e são muito caros para muitas empresas. Os serviços em nuvem oferecem maneiras alternativas e mais simples de treinar e usar a IA generativa, embora com compromissos de controle e personalização. No futuro, a maioria das empresas usará vários métodos de implementação para treinamento e inferência, dependendo dos requisitos específicos do aplicativo.
A Tabela 1 mostra um resumo dos possíveis métodos de implementação para cargas de trabalho de IA divididos por inferência e treinamento. As colunas representam diferentes métodos de implementação. As linhas representam camadas de gerenciamento de carga de trabalho e mostram qual parte, o cliente (C) ou o fornecedor (P), é responsável por cada camada.
Os métodos à direita da Tabela 1 são menos personalizáveis, mas mais fáceis de implementar. Os métodos à esquerda são mais personalizáveis, mas mais difíceis de implementar. Este relatório fornece uma visão geral desses diferentes métodos de implementação.
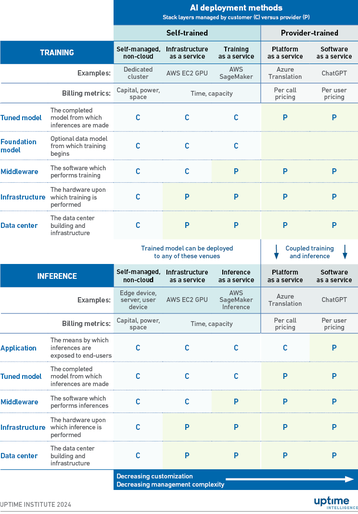
Métodos de implementação de treinamento
Treinado pelo fornecedor
Em um método treinado pelo fornecedor, o fornecedor de nuvem gerencia o treinamento e a inferência do modelo. Existem duas variações:
Software como serviço (SaaS). O fornecedor fornece um aplicativo Web do usuário final. Os usuários finais interagem com o aplicativo para inferência. Os clientes geralmente pagam uma taxa fixa por usuário, como no caso de LLMs como ChatGPT, Microsoft 365 Copilot e o gerador de imagens AI Midjourney.
Plataforma como serviço (PaaS). O fornecedor fornece acesso a serviços de IA por meio de chamadas de interface de programação de aplicativos (API). O cliente arquiteta um aplicativo que usa essas chamadas de API em seu código subjacente para acessar recursos de IA. Por exemplo, o site de uma companhia aérea inclui um chatbot para suporte ao cliente. A companhia aérea gerencia o aplicativo, que envia e recebe solicitações de e para um serviço de chatbot oferecido por um fornecedor de nuvem e configurado pelo cliente.
Os clientes geralmente são cobrados de acordo com o número e o tamanho das solicitações e respostas. Os serviços comuns de PaaS incluem tradução de idiomas (por exemplo, API de tradução do Google), transcrição de fala para texto (por exemplo, API de Análise de Texto do Azure), chatbots (por exemplo, Amazon Lex), reconhecimento de imagem (por exemplo, Amazon Rekognition) e análise de sentimento (por exemplo, IBM Natural Language Processing).
Um fornecedor pode fornecer serviços de PaaS e SaaS com base no mesmo modelo. Por exemplo, a OpenAI fornece inferência por meio de seu próprio front-end da web ChatGPT via SaaS. A OpenAI também fornece inferência por meio de sua API OpenAI via PaaS.
Tanto no SaaS quanto no PaaS, o fornecedor:
- Treina o modelo. Ele provisiona o espaço do data center, configura um cluster de hardware, implementa o modelo no cluster e, em seguida, executa o middleware para treinar o modelo usando dados de treinamento. Ele treina novamente o modelo periodicamente.
- Gerencia a inferência no modelo. O fornecedor provisiona o espaço do data center, configura o hardware apropriado, implanta o modelo no hardware e, em seguida, executa consultas de inferência nesse modelo.
Em ambos os casos, o fornecedor de nuvem possui e atualiza o modelo. O cliente pode configurar o PaaS e o SaaS em um grau limitado, mas essa personalização não afeta o modelo subjacente. Existe um único modelo acessado por muitos clientes.
PaaS e SaaS são os métodos mais fáceis para acessar a funcionalidade baseada em IA, mas oferecem menos personalização.
Autotreinado
Em uma implementação de IA generativa autotreinada, o cliente pode misturar e combinar diferentes métodos de treinamento e inferência.
Os clientes podem optar por desenvolver um modelo do zero ou usar um modelo de base. Um modelo de base é um modelo de IA, que foi pré-treinado por um fornecedor de software. Os exemplos incluem Gemini do Google, Claude da Anthropic, Granite da IBM e GPT-4 da OpenAI.
O valor do modelo de base é que ele fornece um ponto de partida para desenvolvimento adicional, evitando a complexidade e os custos de treinar um modelo do zero. O modelo de fundação foi pré-treinado para uso geral; é o ajuste fino do modelo de base pelo cliente que torna o modelo ajustado adequado para um caso de uso específico. O cliente é responsável por adquirir o modelo, implementá-lo na infraestrutura e ajustá-lo em um modelo ajustado.
Normalmente, a propriedade intelectual de um modelo ajustado por um cliente para um caso de uso específico (de um modelo básico) pertence ao cliente que o treinou.
Os clientes têm várias opções de treinamento:
Controle total. O cliente usa um data center local ou de colocation para hospedar um cluster de servidor dedicado. O cliente treina um modelo do zero ou o modelo de base é treinado novamente usando a própria escolha do cliente de middleware e dados de treinamento.
Existem custos associados a hardware, energia, espaço de data center, outras infraestruturas e habilidades especializadas. O treinamento de IA generativa geralmente requer clusters de GPU que podem custar milhões de dólares para comprar, com o alto consumo de energia dos clusters também gerando custos operacionais.
Esse método é o método de treinamento mais personalizável e controlável, mas geralmente é caro e complexo. Um modelo de base geralmente é criado por um hiperescala ou grande fornecedor de software usando esse método, que é fornecido aos clientes para ajuste fino.
Controle total, além da infraestrutura. O cliente usa infraestrutura de nuvem como serviço (IaaS), incluindo CPUs (por exemplo, AWS EC2), GPUs (por exemplo, GPUs Alibaba Elastic) e armazenamento (por exemplo, Oracle Cloud Object Storage), para treinar seu próprio modelo usando sua própria escolha de middleware e dados de treinamento. Os custos dependem da capacidade utilizada durante o período em que foi utilizada. Os clientes também podem precisar pagar despesas relacionadas a armazenamento, transferência de dados e transações.
Use o treinamento como um serviço. O cliente utiliza uma plataforma de desenvolvimento que automatiza e simplifica alguns aspectos do treinamento. Por exemplo, a plataforma pode gerenciar a distribuição do modelo para recursos de IaaS, dimensionar esses recursos para lidar com requisitos e fornecer acesso a modelos básicos de uma biblioteca. Existem custos associados ao consumo de serviços em nuvem sob demanda para treinamento de modelo e a própria plataforma de desenvolvimento. Os modelos de base podem ser precificados pelo número de tokens (componentes de frases) colocados no modelo e extraídos. Exemplos de plataformas incluem Amazon SageMaker, Google Vertex AI e Microsoft Azure Machine Learning.
Inferência. Dependendo do método de treinamento e do software usado, o modelo treinado pode ser implementado em vários locais para inferência. Um modelo treinado usando um método geralmente pode ser implementado para inferência usando um método diferente. Como a inferência é um componente de um aplicativo maior, ela geralmente é implantada perto do restante dos recursos do aplicativo para reduzir a latência. O modelo treinado é um pacote de código e pesos que calcula a saída (uma classificação ou previsão) de qualquer entrada, como uma consulta de usuário.
Implementação em equipamentos dedicados
O treinamento geralmente requer servidores poderosos executando GPUs. No entanto, a inferência pode ser otimizada e simplificada para ser executada em dispositivos menos potentes, incluindo servidores padrão, dispositivos de usuário final, ASICs (circuitos integrados específicos de aplicativos) personalizados e dispositivos de borda. Nesse método, o cliente gerencia o hardware, o middleware e o modelo de inferência.
Implementação em IaaS
Para inferência, os modelos de aprendizado de máquina podem ser instalados no IaaS. Uma máquina virtual normalmente hospeda o código que executa a inferência, com acesso a recursos de GPU ou ASIC, se necessário. O cliente é responsável por dimensionar a infraestrutura com a demanda em constante mudança. Além dos custos da máquina virtual, também pode haver custos relacionados ao armazenamento, transferência de dados e transações.
Implementação em serverless, inferência como serviço
Uma plataforma sem servidor permite que os clientes executem código sem controle (ou visibilidade) da infraestrutura subjacente. O cliente fornece o código ao operador de nuvem; o operador de nuvem assume a responsabilidade de executar esse código de acordo com as regras e gatilhos configurados pelo cliente.
Em um serviço de inferência sem servidor, o fornecedor de nuvem executará o modelo, geralmente respondendo a consultas de API do aplicativo do cliente para a plataforma sem servidor. Os clientes são cobrados por essas consultas e pelo armazenamento do modelo. Os exemplos incluem o Amazon SageMaker Serverless Inference e o Azure AI Model Inference.


Comments