
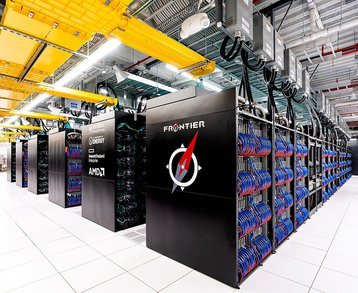
Pesquisadores do Oak Ridge National Laboratory publicaram um artigo de pesquisa detalhando como treinaram um LLM de um trilhão de parâmetros no supercomputador Frontier usando apenas 3.072 de suas 37.888 GPUs.
A equipe também detalhou como foi capaz de treinar um LLM de 175 bilhões de parâmetros usando apenas 1.024 GPUs do supercomputador. Um LLM de um trilhão de parâmetros está na mesma escala do modelo GPT4 da OpenAI.
Há uma série de desafios que vêm com o treinamento de LLMs com bilhões de parâmetros, como os consideráveis recursos de computação e memória necessários. Para superar isso, os pesquisadores investigaram técnicas de treinamento paralelo de dados e sua pegada de memória, latência de comunicação e eficiência computacional da GPU. Isso permitiu que os pesquisadores usassem o “ajuste de hiperparâmetros” para encontrar as estratégias mais eficientes para o treinamento de grandes LLMs.
Os resultados mostraram taxas de transferência de GPU de 31,96% alcançadas para o modelo de um trilhão de parâmetros e 36,14% para o modelo de parâmetros de 17 bilhões. Além disso, para ambos os modelos, os pesquisadores alcançaram 100% de eficiência de escala fraca e eficiências fortes de escala de 89% para o modelo de parâmetros de 175 bilhões e 87% para o modelo de um trilhão de parâmetros.
No entanto, o artigo de pesquisa não forneceu nenhuma informação sobre quanto tempo levou para treinar os modelos usando esse método.
O supercomputador Frontier tem uma pontuação de benchmark HPL (High-Performance Linpack) de 1.194 exaflops, usa processadores AMD Epyc 64C 2GHz e é baseado na arquitetura HPE Cray EX235a. O sistema tem um total de 8.699.904 núcleos combinados de GPU e CPU, e usa a rede Slingshot 11 da HPE para transferência de dados.
Em novembro de 2023, ficou no primeiro lugar da lista Top500 dos supercomputadores mais rápidos do mundo.


Comments