

Con frecuencia hablamos de inteligencia artificial (IA) y consumo de energía del centro de datos desde una perspectiva macro.
Las estadísticas son innegables, inevitables y, francamente, alarmantes. El informe de octubre de la Agencia Internacional de la Energía concluyó que el consumo global de electricidad de los centros de datos aumentaría significativamente para 2030, citando la IA y la digitalización como un factor impulsor.
En diciembre de 2024, el Departamento de Energía de EE. UU. descubrió que, si bien los centros de datos consumieron alrededor del 4,4 por ciento de la energía del país en 2023, esta cifra podría aumentar al 12 por ciento en 2028, todo ello mientras la generación de energía en sí también está creciendo.
La IA está disparando las demandas de energía de los centros de datos por dos razones clave: las GPU que requiere tienen un alto consumo de energía y el entrenamiento de los modelos de IA requiere muchas de estas GPU.
Si bien la startup china DeepSeek afirma haber entrenado su modelo utilizando mucho menos hardware que sus rivales en Occidente, para la mayoría de las empresas el desarrollo de IA sigue siendo una actividad que requiere muchos recursos.
Pero dentro de las enormes cifras, los campus de gigavatios y las decenas de miles de GPU por clúster, se encuentran las minucias: los microsegundos. El consumo de energía en el contexto del tiempo.
Las cargas de trabajo de IA (la IA generativa y el entrenamiento de grandes modelos lingüísticos en particular) exigen una gran cantidad de energía en apenas una fracción de segundo, y esto en sí mismo genera algunas complicaciones.
"Cuando se utiliza un modelo de entrenamiento, se utilizan todas estas GPU simultáneamente y se produce un aumento muy rápido hasta alcanzar prácticamente la potencia máxima, y estamos viendo que esto ocurre a un ritmo inferior a un segundo", explica Ed Ansett, director de I3 Solutions, a DCD.
El problema es que, por ejemplo, la compañía eléctrica está a punto de recibir una carga de TI de 50 MW, pero la recibirá muy rápidamente y no podrá responder con la misma rapidez. Esto causará problemas de frecuencia y es casi seguro que desconectará el centro de datos, por lo que es necesario encontrar una forma de amortiguar esas cargas de trabajo.
En diciembre de 2024, el Laboratorio Nacional Lawrence Berkeley publicó el Informe de uso de energía del centro de datos de Estados Unidos de 2024, que analizó el consumo de energía irregular de las cargas de trabajo de entrenamiento de IA.
Ese informe explica que, si bien las GPU suelen realizar la mayor parte de los cálculos para las cargas de trabajo de entrenamiento de IA, funcionan como parte de nodos complejos que incluyen "unidades centrales de procesamiento (CPU) supervisoras, memoria e interconexión de alto ancho de banda".
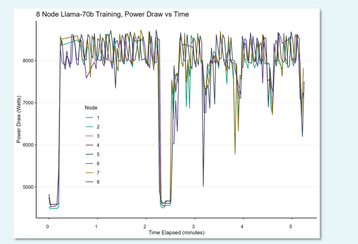
“Esta integración significa que cada componente puede limitar la capacidad de otros, creando perfiles de carga característicos”, afirma el informe. “Las mediciones empíricas demuestran consistentemente que, incluso con cargas de trabajo computacionalmente intensivas, la demanda de energía a nivel de nodo rara vez se acerca a los máximos especificados por el fabricante”.
El informe continúa señalando que “la fluctuación característica en la demanda de energía para el entrenamiento de IA en comparación con las cargas de trabajo de HPC más convencionales... puede ser especialmente exigente para los operadores de la red”.
Por supuesto, esto tiene sus matices, dependiendo de la empresa de servicios públicos y la región. Es una cuestión de escala: el tamaño del centro de datos y el consumo energético que representa para la empresa.
Pero se están observando consecuencias reales en la red eléctrica. Un informe reciente de Bloomberg, basado en datos de Whisker Labs y DC Byte, reveló que las cargas de trabajo masivas de IA están generando armónicos negativos en la red.
El informe describe los armónicos deficientes como una distorsión causada por un consumo excesivo de energía, comparándolos con la estática que se escucha cuando el volumen de un altavoz es demasiado alto. El resultado no es una gradación uniforme del consumo de energía, sino una con subidas y bajadas rápidas, que según Bloomberg, está afectando a las residencias cercanas. "Cuanto peor es la calidad del suministro eléctrico, mayor es el riesgo", afirma el informe. "Las subidas o bajadas repentinas del suministro eléctrico pueden provocar chispas e incluso incendios domésticos".
Según Bloomberg, más de la mitad de los hogares monitoreados por la calidad de la energía que mostraron las peores distorsiones en la calidad de la energía estaban a 32 kilómetros de "actividad significativa en un centro de datos".
Esta actividad podría referirse a una instalación a hiperescala o a un grupo de centros de datos en un área.
En declaraciones a Bloomberg, Dominion Energy, que presta servicios en el norte de Virginia, entre otras regiones, dijo que no había notado los mismos niveles de distorsión que mostraban los datos de Whisker Labs, pero que "en algunos casos excepcionales, hemos observado períodos muy breves de interrupción armónica más alta de lo normal debido a configuraciones anormales o problemas con los equipos cuando una nueva instalación se pone en funcionamiento por primera vez".
Giovanni Zanei, vicepresidente de convertidores de gran potencia de Vertiv, admitió que se trataba de un problema de escala. «Unos pocos megavatios podrían no ser un problema tan grande», afirma. «Un centro de datos de 100 MW es, sin duda, una historia distinta».
Si bien hay algunas implementaciones de IA más pequeñas, la tendencia en la industria es que los hyperscalers y las principales empresas tecnológicas implementen clústeres de GPU masivos.
En octubre de 2024, Tesla dijo que lanzaría un clúster de 50.000 GPU en Texas y planeó un clúster de 300.000 GPU Nvidia Blackwell B200 para el verano de 2025. La empresa de inteligencia artificial xAI de Elon Musk tiene un clúster de 200.000 GPU denominado Colossus, que, según afirma, finalmente se ampliará a un millón de chips.
Mientras tanto, Oracle ofrece un supercúmulo compuesto por más de 65.000 GPU y recientemente lanzó un supercúmulo de escala zetta con alrededor de 131.072 GPU Blackwell. Empresas como Meta, Amazon Web Services, Google y Microsoft también han adquirido GPU no a puñados, sino a montones.
El consumo de energía de las GPU individuales es cada vez mayor: se espera que la GPU B200 de la gama Blackwell consuma hasta 1200 W, mientras que la GB200 (que incluye dos GPU B200 combinadas con una CPU Grace) podría alcanzar los 2700 W.
Encendido
Cuando se trata del encendido rápido de cantidades masivas de GPU, Ansett de i3 ve que los clientes recurren a las baterías para "amortiguar" la carga de TI, y señala: "Las baterías hacen el trabajo pesado a corto plazo, pero esa carga luego se puede transferir a los servicios públicos".
Sin embargo, Zanei de Vertiv no considera que las baterías sean una solución ideal para este problema, y señala que dentro del rápido aumento del consumo de energía se encuentra el problema matizado de la caída de tensión.
El proveedor ha estado realizando pruebas para abordar la caída de tensión con sus sistemas de alimentación ininterrumpida (SAI) de 1 MW. "Lo probamos para ver la magnitud y la velocidad con la que se produce, y puede variar fácilmente desde, digamos, el 30 o 40% de la carga hasta el 150% en cuestión de milisegundos, para luego permanecer así durante unos 10 o 20 milisegundos y volver a bajar", afirma Zanei.
Esto complica aún más el asunto. No solo se envía una demanda repentina y masiva de energía a la compañía eléctrica, sino que en menos de un segundo podría desaparecer y luego volver. Es la definición de "señales contradictorias".
Según Zanei, el problema no se limita al proveedor de servicios públicos. Ese espasmo es grave, independientemente de la fuente de energía.
“Siempre que un centro de datos tenga que funcionar con generadores, a estos no les va a gustar esta caída de tensión”, afirma. “O, en el caso de un centro de datos que funciona con energía primaria, pero no con la red eléctrica, por ejemplo, con turbinas de gas. De nuevo, a las turbinas de gas no les va a gustar, y sería necesario sobredimensionarlas considerablemente para evitar un problema”.
Luego están las baterías. Zanei dice que: «Las baterías están diseñadas para uso de respaldo, y suelen usarse de vez en cuando. Pero no están diseñadas para esta frecuencia; podrían ser cientos o miles de veces al día».
“Incluso las baterías con un mayor tiempo de ciclo no están hechas para eso, y ciertamente no habría garantía disponible”. Zanei agrega que, si tuviera que hacer una estimación, esperaría un costo tan alto.
Las cargas de trabajo podrían reducir a la mitad la vida útil de la batería. Zanei señala que contar con inteligencia dentro del SAI para amortiguar o al menos suavizar algunas de las fluctuaciones de energía es algo que Vertiv está observando en sus clientes.
Vertiv también está asesorando a los clientes sobre el uso de UPS y baterías para la caída de tensión, en relación con cuestiones como el tamaño necesario, el tipo de contenedor y si tener baterías y sistemas UPS separados para el centro de datos y este propósito exacto sería la mejor solución.
Como alternativa, los ultracondensadores podrían ser la solución a largo plazo, afirma Zanei. «El ultracondensador es una especie de solución de almacenamiento de energía, y es muy eficaz para la entrada y salida de energía», explica. «Almacena menos energía [que una batería], pero es excelente para ciclos muy rápidos y podría proporcionar la energía necesaria solo durante esos milisegundos, o durante el breve pico, y luego recargarse durante los valles».
Schneider Electric, por otro lado, ha incorporado capacidades de suavizado de energía en sus UPS.
Mustafa Demirkol, vicepresidente de sistemas de centros de datos de Schneider Electric, explica que las soluciones de almacenamiento de energía ya están "incorporadas a nuestra topología" y añade: "Estábamos preparados para esto antes de que surgieran las fluctuaciones de la IA, porque también las veíamos en otras aplicaciones".
Al analizar las fluctuaciones de carga de la IA, es necesario considerarlas de forma integral. Y no se trata solo del SAI, sino del servidor. Es posible que se necesiten mejoras y recursos. El SAI debe ser lo suficientemente robusto como para soportar este tipo de estrés y fluctuaciones de carga, y, al mismo tiempo, es necesario considerar todo el sistema, no solo el SAI, sino también el equipo de conmutación. Todo debe ser capaz de gestionar este tipo de presupuesto.
Soluciones a nivel de chip
Zanei, de Vertiv, afirma que su equipo mantiene conversaciones frecuentes con las empresas de chips. "Cuando hablo con los responsables de chips, queda claro que se trata de garantizar que las GPU, o los servidores en general, funcionen al máximo rendimiento. Necesitan que sus GPU y el propio centro de datos funcionen de esta manera. Y la forma en que se consume la carga, es decir, la energía que consumen sus servidores, es bastante sincronizada".
DCD contactó a varios fabricantes de GPU para obtener información sobre cómo podrían diseñar sus chips para evitar esto y si están haciendo algún esfuerzo para resolver el problema. Ninguno quiso hacer comentarios al respecto.
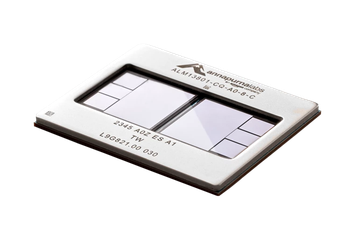
A pesar de esto, AWS y Annapurna Labs han realizado algunos cambios con la segunda generación de su acelerador de IA de desarrollo propio, Trainium. Estos chips se diferencian de las GPU tanto en su arquitectura como en sus capacidades finales.
“Si observamos la arquitectura de la GPU, se trata de miles de pequeños núcleos tensoriales, pequeñas CPU que funcionan en paralelo. En este caso, la arquitectura se denomina matriz sistólica, una arquitectura completamente diferente”, afirma Gadi Hutt, director de ingeniería de producto y cliente de Annapurna Labs. “Básicamente, los datos fluyen a través de la lógica de la matriz sistólica, que luego realiza la eficiente aceleración del álgebra lineal”.
Otros diseñadores de chips han adoptado un enfoque similar, como Furiosa AI.
Trainium se diseñó para cargas de trabajo de entrenamiento de IA y no cuenta con las capacidades informáticas de propósito general que se observan en las GPU. "No puede generar gráficos ni pronósticos meteorológicos, ni todo lo que las GPU hacen muy bien", afirma Hutt. "Pero estos chips están diseñados para procesar álgebra lineal, acelerar el álgebra lineal y mantener el ritmo con un uso intensivo".
Peter DeSantis, vicepresidente sénior de informática de servicios públicos en AWS, analizó durante su discurso de apertura en AWS Re:Invent 2024 titulado "La complejidad de las leyes de escalamiento de la IA: la física detrás de la maximización del potencial de las GPU (u otros aceleradores) para las cargas de trabajo de la IA".
Citando un artículo de 2020, "Leyes de Escalado para Modelos de Lenguaje Neural", DeSantis describió las cargas de trabajo de IA como "de escala vertical", no "de escala horizontal". Las leyes de escalado planteaban la hipótesis de que las capacidades del modelo mejoran al escalar diversos factores, como el número de parámetros, el conjunto de datos, el tamaño y la cantidad de cómputo.
Como resultado, ha habido un impulso constante y considerado hacia modelos más grandes y con mayor intensidad de procesamiento que de hecho se han vuelto más capaces, con el objetivo de reunir la mayor cantidad de procesamiento y memoria de alta velocidad en el menor espacio posible, conectados entre sí con conectividad de baja latencia.
El “mínimo espacio posible” es quizás el elemento clave.
Los espacios más pequeños implican mayor proximidad, por lo que se utilizan cables más cortos y conexiones con menor latencia. Como explica DeSantis: «Si tienes cosas más cerca, puedes usar cables más cortos para transmitir datos entre ellas, lo que significa que puedes incluir más cables. También significa menor latencia y se pueden usar protocolos más eficientes para intercambiar datos. Esto parece bastante sencillo, pero es un reto muy interesante».
Los chips de AWS también requieren mucha energía, lo que conlleva el problema de la caída de voltaje. Una de las maneras en que se ha ajustado el chip Trainium2 para evitar esto es mediante el uso de cables relativamente grandes (vías de alimentación), lo que les permite transportar energía a bajos voltajes.
Un semiconductor utiliza la presencia o ausencia de pequeñas cargas eléctricas para almacenar y procesar información. Por lo tanto, cuando los chips experimentan caídas de tensión, normalmente deben esperar hasta que el sistema de suministro de energía se ajuste, y esperar no es algo que se desee hacer con un chip», afirma DeSantis.
En realidad, es mucho más eficiente mover energía a voltajes más altos en un centro de datos, por lo que la energía se reduce progresivamente a medida que se acerca a los chips, cuya etapa final es antes de ingresar al paquete.
Según DeSantis, esto se logra generalmente mediante reguladores de voltaje ubicados lo más cerca posible del encapsulado. Para reducir la caída de voltaje en comparación con el chip Trainium1, Annapurna Labs ha colocado los reguladores de voltaje aún más cerca del chip, de hecho, bajo el perímetro del encapsulado.
Hacer esto es todo un reto, ya que los generadores de voltaje generan calor, por lo que es necesario implementar ingeniería innovadora. Pero al acercar esos reguladores de voltaje al chip, podemos usar cables más cortos, lo que implica una menor caída de voltaje.
Es posible que AWS haya podido resolver este problema a nivel de chip para sus chips Trainium2, pero en última instancia el diseño mismo de las GPU hace que no sea realista que veamos una resolución a nivel de chip sin que revolucionen fundamentalmente su enfoque.
Y, en general, esa no será la prioridad. Sí, tienen sus picos de rendimiento incorporados, pero las GPU también son increíblemente potentes y populares. El incentivo para reinventarse es limitado.
Mientras tanto, los operadores de centros de datos tendrán que recurrir a sus UPS con la esperanza de suavizar el perfil de energía de las cargas de trabajo de entrenamiento de IA.
De no hacerlo, las consecuencias para la red podrían ser graves. Los operadores de centros de datos también podrían verse afectados.
Como señala Demirkol de Schneider Electric: “Probablemente habrá fallas en el nivel ascendente e incluso se podrían dañar las GPU”.
Este reportaje ha sido traducido y editado al español por Gabriel Carrillo M-Feduchi


Comments