
Nvidia sigue creciendo.
A finales del año pasado, el gigante tecnológico se hizo con la startup de chips Groq en una compleja operación de 20 000 millones de dólares (101 200 millones de reales). No se trató de una adquisición —una formalidad engorrosa que conlleva supervisión regulatoria—, sino de una contratación casi total de la plantilla y la obtención de licencias de tecnología.
Este artículo se publicó originalmente en el suplemento de Hardware de IA. Léelo gratis aquí.
«Fue muy rápido», declaró Ian Buck, vicepresidente y director general de Hyperscale y HPC de Nvidia, a DCD sobre el acuerdo, anunciado la víspera de Navidad de 2025. El director ejecutivo de Groq, Jonathan Ross, «recibió su portátil de Nvidia el día de Navidad; mantuvimos una reunión inicial el día 27 y, desde entonces, ha sido increíble».
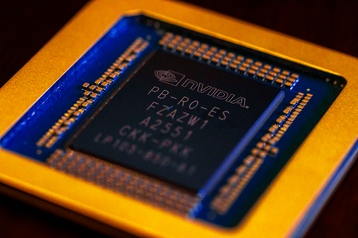
Este ritmo acelerado continuó: en marzo, Nvidia anunció que lanzaría chips basados en Groq antes de que acabara el año, junto con nuevas GPU y CPU, y que se lanzarían más chips Groq cada año.
La rapidez del acuerdo despertó sospechas, y algunos lo interpretaron como una jugada desesperada de una fuerza dominante que busca mantener su dominio en el mercado de la computación de IA. Nvidia vio cómo se disparaba su capitalización bursátil con el argumento de que la GPU es el chip definitivo para todo lo relacionado con la computación acelerada. Ahora, ha lanzado una alternativa —y ha tenido que buscarla fuera de la empresa para encontrarla—.
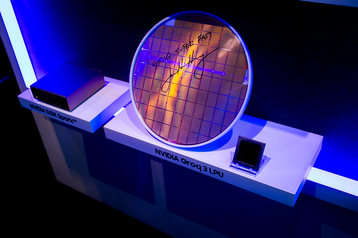
Buck tiene una respuesta. «En el 75 % de los casos de uso, ese chip aporta muy poco o ningún valor», afirma, mientras muestra un Groq 3, la visión de la empresa sobre el hardware de Groq. La unidad de procesamiento del lenguaje, o LPU, está orientada a la inferencia de IA ultrarrápida y de baja latencia en la era de la IA agente.
La clave de su velocidad es la memoria de acceso aleatorio estática (SRAM). «La SRAM es el tipo de memoria más cara», afirma Buck. «Pero es extremadamente rápida. Es siete veces más rápida que la HBM, la tecnología de memoria más rápida aparte de la SRAM que utilizamos y que también se emplea en sus GPU.
Mientras que la HBM se encuentra junto a las GPU, la SRAM está en el propio chip, lo que significa que los datos no tienen que desplazarse de un lado a otro.
Sin embargo, el reto con la LPU es que la cantidad de SRAM es relativamente pequeña: 500 MB. Incluso cuando se combinan 256 LPU en un único rack, esto supone 128 GB de SRAM en el chip, por debajo de los 288 GB de HBM4 en un solo Vera Rubin.
Ahí es donde Groq, la empresa, tuvo dificultades, pero Groq, la tecnología, brillará, argumenta Nvidia. En lugar de esperar que la LPU compita, la empresa la tratará como un complemento de la GPU, desglosando las operaciones matemáticas y transfiriendo las partes adecuadas de la carga de trabajo al chip adecuado.
La empresa ofrecerá el hardware únicamente a gran escala, con 256 chips combinados en un rack Nvidia Groq 3 LPX. Cada bandeja del rack alberga ocho LPU Groq 3. A continuación, se configura para integrarse junto con un rack NVL72 de Vera Rubin, de modo que las tareas más pesadas y que requieren mayor consumo computacional se realicen en las GPU, mientras que el trabajo de latencia extremadamente baja se transfiera a las LPU.
Tomando como ejemplo un chatbot, Buck explica: «Cuando empiezas a agrupar el contexto, todo lo que has dicho en el chat anterior tiene que introducirse y procesarse realmente junto con el modelo. Ese fue uno de los mayores retos para la LPU en la época de la empresa Groq, porque no podían acomodar toda esa memoria de contexto en los lotes completos que estaban procesando. Pero podemos realizar todo ese procesamiento aquí», dice, mostrando un Rubin, «gracias a la memoria HBM».
«La HBM y la GPU se encargan de “todas las funciones softmax y de todas las operaciones de enrutamiento”. No necesitamos enviar ningún cálculo KV a la LPU. La LPU puede centrarse únicamente en los pesos. Tenemos que colocar todos los pesos allí, pero solo una copia».
La división de la carga de trabajo «no es una desagregación tradicional, en la que los tokens de entrada son procesados por la GPU y las decodificaciones las realizan algunos ASIC», argumenta Buck. «En realidad lo estamos fusionando todo, aprovechando el software en el que hemos invertido con Dynamo y en el que ellos han invertido en Groq, para poder mover rápidamente los tokens entre los dos procesadores».
El director ejecutivo y fundador, Jensen Huang, ofreció una explicación más sucinta durante una breve conversación: «Para el consumo principal de tokens, Vera Rubin es imbatible. Groq no va a cambiar eso. Sin embargo, creemos que está surgiendo un nuevo segmento en el que los modelos deben ser a la vez grandes, con un contexto amplio y una latencia extremadamente corta.
«Groq puede cumplir una de estas tres promesas, pero no todas. Sin embargo, combinando Vera Rubin y Groq, podemos cumplir estas tres promesas para crear ese segmento: modelo grande, contexto amplio y tokens ultrarrápidos».
La visión optimista de Huang corre el riesgo de ocultar un mensaje más amplio detrás de sus comentarios: las GPU siguen siendo la columna vertebral del auge de la IA, pero se reconoce que hay espacio en los extremos del espectro de cargas de trabajo para chips alternativos, aunque complementarios.
Otras empresas de chips de inferencia basados en SRAM, desde d-Matrix hasta Cerebras, han aprovechado la noticia para afirmar que esto valida su enfoque —que a menudo no incluye el margen de Nvidia—.
La LPU Groq 3 es, en muchos aspectos, un chip desarrollado por otra empresa. Este lanzamiento inicial presenta signos de una integración rápida, con una mezcla de tecnología de Nvidia, licencias de Groq y hardware de terceros.
«Obviamente, estaban trabajando en la versión 2 del chip de Groq», afirma Buck. «Hemos conseguido acelerar el desarrollo de la versión 2 para que la versión 3 esté ya en nuestras manos. Desde el punto de vista del silicio, obviamente, es muy similar a lo que ya tenían, pero lo que no tenían era un factor de forma de alta densidad con refrigeración líquida».
La LPU se parecerá cada vez más a Nvidia, con la LPU 35 llegando el año que viene y la LPU 40 junto con la gama de GPU Feynman. Este último chip abandonará la interconexión personalizada de Groq en favor del popular NVLink de Nvidia y añadirá compatibilidad con NVLink 4.0.
El procesador del LPX de primera generación ni siquiera procede de Nvidia; aunque la empresa se ha negado a revelar el hardware, los racks que ha podido ver DCD parecen incluir chips AMD Epyc.
Es probable que, en algún momento, Nvidia migre a su propia línea de CPU, que se actualizará este año con la CPU Vera.
Al igual que la LPU, está optimizada para la era de la agencia.
«El futuro empieza a parecerse un poco más a un sistema de agentes, en el que las IA conversan entre sí», afirma Buck. «Los LLM son IA que hablan con humanos; simplemente eliminábamos a los humanos del circuito; así que, básicamente, se trata de la velocidad a la que un agente puede comunicarse con otro agente. No está limitada por la percepción humana».
Nvidia entró en el mercado de las CPU para centros de datos en 2023 con el chip Grace, basado en los núcleos Arm Neoverse. El chip, anunciado por primera vez en 2021, se adelanta a gran parte del auge de la IA, por no hablar de la actual fiebre por los agentes.
«Resulta que la carga de trabajo necesaria para conectarse a una GPU es muy similar a la que necesita el agente», afirma Buck. «Hay un procesamiento inicial de KV, procesamiento de datos y, por supuesto, núcleos rápidos, porque no queríamos que estas GPU fueran lentas».
Se refiere a la Ley de Amdahl, según la cual la velocidad máxima teórica de un sistema viene limitada por la parte de la tarea que no se puede paralelizar. Grace se desarrolló simplemente para garantizar que la GPU Blackwell alcanzara todo su potencial.
«Tenemos que asegurarnos de que siempre aspiramos a alcanzar el mayor rendimiento posible de la CPU de un solo hilo, para mantener la GPU ocupada».
El director ejecutivo Huang añade: «La IA no tiene que ver con los núcleos, sino con el trabajo. Cuando tienes 50 000 millones de dólares (253 000 millones de reales) en GPU ahí, desde luego no vas a dejar esas GPU inactivas mientras 1 000 millones de dólares (5 600 millones de reales) en CPU hacen su trabajo.
«Hay que terminar el trabajo de las CPU lo antes posible para que los 50 000 millones de dólares en GPU nunca se queden paradas. Esto significa que nuestros requisitos de CPU son sustancialmente diferentes. Y, como resultado, hemos creado CPU muy diferentes».
Pero lo que ocurrió fue que los clientes empezaron a utilizar cada vez más las CPU Grace, incluso como gestor de caché KV en memoria en toda la flota de computación. «Así, por ejemplo, para la inferencia, llega tu consulta; tu memoria KV se ha fragmentado en varios nodos para que puedan programar qué GPU atenderá tu próxima consulta de LLM», explica Buck. «Y luego, a medida que actualizas, mantienen esa base de datos activa y sincronizan todas las cachés KV».
Meta fue la primera empresa en anunciar públicamente que estaba utilizando tanto el Grace conectado a una GPU como un sistema independiente, pero DCD tiene entendido que otras empresas también están implementando CPU de Nvidia independientes.
Con la próxima Vera, Nvidia está apuntando a este mercado de forma más agresiva. «Este es nuestro próximo negocio de mil millones», afirma Buck.
«Ahora puedo realizar tareas de agente en la CPU», explica. «Por eso se está produciendo esta explosión en el ámbito de la CPU».
A pesar de este auge, que ha contribuido a impulsar las cotizaciones bursátiles de Intel y AMD, Buck califica las CPU de «un mercado descuidado».
Y añade: «Se volvió aburrido porque la gente simplemente se dedicaba a construir otro procesador con más núcleos y se centraba en los dólares por núcleo. Nunca se oye hablar de rendimiento. Siempre se oye hablar de dólares por núcleo, dólares por núcleo. Como resultado, la ingeniería de estos procesadores para centros de datos ha evolucionado hasta el punto de dejar de valorar la mejora del rendimiento».
Lo contrario ocurrió en el mundo de los ordenadores personales, donde toda la atención se centraba en el rendimiento y en un número reducido de núcleos. «Por desgracia, esto no va a funcionar para los operadores que quieren muchos núcleos y que todos sean rápidos».
Vera cuenta con 88 núcleos, notablemente menos que muchos de sus competidores en los centros de datos. «Menos núcleos, pero los núcleos son más rápidos, y la estructura que conecta todos esos núcleos es mucho más resistente», replica Buck. «Tiene el triple de ancho de banda de memoria por núcleo que el x86 y el doble de eficiencia energética».
Para finales de año, Nvidia espera lanzar Vera, junto con la nueva GPU Rubin y la LPU Groq.
«Éramos una empresa de GPU», recuerda Buck. «Después, adquirimos Mellanox y nos convertimos en una empresa de GPU, además de NV Switch, Spectrum, Quantum, CX y así sucesivamente. Y ahora también Bluefield, Grace y LPU.
«No se puede dar respuesta a todo el mercado de la IA sin los siete chips y los cinco racks diferentes. El alcance se está ampliando; los modelos no hacen más que crecer. Todas las diferentes modalidades de IA siguen desarrollándose».
Huang también echó la vista atrás. «Empezamos con la Riva 128», afirma, pasando por alto convenientemente la NV1, menos exitosa, que la precedió. «Solo teníamos un producto; ahora tenemos el 5050, el 5060 y el 5090, y todo tipo de productos. No es diferente de los inicios del iPhone; ahora hay muchísimas versiones.
«Tenemos clientes con necesidades y rangos de precios diferentes, etc. Por eso hemos ido ampliando esta gama».



Comments