
A Nvidia está ficando maior.
No final do ano passado, o gigante da tecnologia engoliu a startup de chips Groq em um acordo complexo de 20 bilhões de dólares (101,2 bilhões de reais). Não foi uma aquisição, uma formalidade incômoda que inclui supervisão regulatória, mas sim uma contratação quase total de funcionários e licenciamento de tecnologia.
Essa matéria foi originalmente publicada no suplemento de Hardware de IA. Leia gratuitamente aqui.
"Foi muito rápido", Ian Buck, vice-presidente e gerente geral da Hyperscale e HPC da Nvidia, informou à DCD sobre o acordo, anunciado na véspera de Natal de 2025. O CEO da Groq, Jonathan Ross, "recebeu seu laptop da Nvidia no dia de Natal; fiz uma reunião de abertura no dia 27 e, desde então, tem sido incrível."
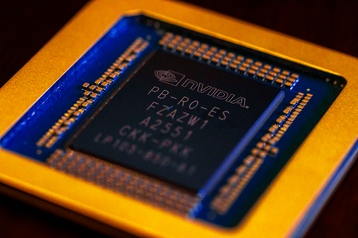
Esse ritmo acelerado continuou: em março, a Nvidia anunciou que lançaria chips baseados em Groq antes do final do ano, junto com novas GPUs e CPUs, e que mais chips Groq seriam lançados anualmente.
A rapidez do acordo levantou suspeitas, com alguns vendo isso como uma jogada desesperada de uma força dominante que busca manter seu domínio no mercado de computação de IA. A Nvidia viu sua capitalização de mercado disparar com o argumento de que a GPU é o chip definitivo para tudo relacionado à computação acelerada. Agora, ela lançou uma alternativa – e teve de procurar fora da empresa para encontrá-la.
Buck tem uma resposta. "Em 75% dos casos de uso, esse chip agrega muito pouco ou nenhum valor", diz ele, mostrando um Groq 3, a visão da empresa sobre o hardware da Groq. A unidade de processamento de linguagem, ou LPU, é voltada à inferência de IA ultrarrápida e de baixa latência na era da IA agêntica.
A chave para sua velocidade é a memória de acesso aleatório estática (SRAM). "SRAM é o tipo de memória mais cara", diz Buck. "Mas é extremamente rápido. Isso é sete vezes mais rápido do que usar HBM, a tecnologia de memória mais rápida fora da SRAM que usamos e que também é usada em suas GPUs.
Enquanto o HBM fica ao lado das GPUs, a SRAM está no próprio chip, o que significa que os dados não precisam viajar de um lado a outro.
No entanto, o desafio com a LPU é que a quantidade de SRAM é relativamente pequena: 500 MB. Mesmo quando 256 LPUs são combinadas em um único rack, isso dá 128 GB de SRAM no chip – abaixo dos 288 GB do HBM4 em um único Vera Rubin.
Foi aí que a Groq, a empresa, teve dificuldades, mas a Groq, a tecnologia, vai brilhar, argumenta a Nvidia. Em vez de esperar que a LPU concorra, a empresa a tratará como um complemento da GPU, desagregando a matemática e transferindo as partes certas da carga de trabalho para o chip adequado.
A empresa oferecerá o hardware apenas em massa, com 256 chips combinados em um rack Nvidia Groq 3 LPX. Cada bandeja do rack abriga oito LPUs Groq 3. Depois, ele é configurado para ser empacotado junto com um rack NVL72 da Vera Rubin, com as partes mais pesadas e de maior consumo de computação realizadas nas GPUs e o trabalho de extrema baixa latência transferido para as LPUs.
Usando um chatbot como exemplo, Buck explica: "Quando você começa a agrupar seu contexto, tudo o que você disse no chat anterior precisa ser realmente alimentado e processado junto com o modelo. Esse foi um dos maiores desafios para a LPU da era da empresa Groq, porque eles não conseguiam acomodar toda aquela memória de contexto nos lotes completos que estavam processando. Mas podemos fazer todo esse processamento aqui", ele diz, brandindo um Rubin, "com a memória HBM."
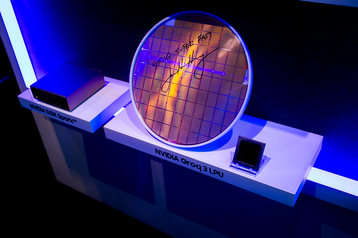
O HBM e a GPU cuidam de "todas as funções de softmax e de todas as operações de roteamento". Não precisamos enviar nenhum cálculo de KV para a LPU. A LPU pode estar focando apenas nos pesos. Temos que colocar todos os pesos ali, mas só uma cópia."
A divisão da carga de trabalho "não é uma desagregação tradicional, em que tokens de entrada são processados pela GPU e decodificações são feitas por alguns ASICs", argumenta Buck. "Estamos realmente fundindo tudo, aproveitando o software em que investimos com a Dynamo e em que eles investiram na Groq, para que possamos mover rapidamente os tokens entre os dois processadores."
O CEO e fundador, Jensen Huang, deu uma explicação mais sucinta durante uma breve interação: "Para o principal consumo de tokens, Vera Rubin é imbatível. A Groq não vai mudar isso. No entanto, acreditamos que está surgindo um novo segmento em que os modelos precisam ser simultaneamente grandes, o contexto grande e a latência extremamente curta.
"A Groq pode cumprir uma dessas três promessas, mas não todas. No entanto, combinando Vera Rubin e Groq, podemos cumprir essas três promessas para criar esse segmento: modelo grande, grande contexto e tokens super-rápidos."
A representação otimista de Huang corre o risco de mascarar uma mensagem mais ampla por trás dos comentários – as GPUs ainda são a espinha dorsal do boom da IA, mas há uma admissão de que há espaço nas bordas do espectro de carga de trabalho para chips alternativos, embora complementares.
Outras empresas de chips de inferência baseadas em SRAM, da d-Matrix à Cerebras, começaram a notícia alegando que isso valida sua abordagem – que muitas vezes não inclui a margem da Nvidia.
A LPU Groq 3 é, em muitos aspectos, um chip desenvolvido por outra empresa. Esse lançamento inicial traz marcas de uma integração rápida, com uma mistura de tecnologia da Nvidia, licenças da Groq e hardware de terceiros.
"Eles obviamente estavam trabalhando na V2 do chip da Groq", diz Buck. "Conseguimos acelerar o V2 para que o V3 esteja em nossas mãos. Do ponto de vista do silício, obviamente, é muito parecido com o que já tinham, mas o que eles não tinham era um fator de forma de densidade com solução de resfriamento líquida."
A LPU vai se tornar cada vez mais Nvidia, com a LPU 35 chegando no próximo ano e a LPU 40 junto com a linha de GPUs Feynman. Esse último chip vai abandonar a interconexão personalizada da Groq em favor do popular NVLink da Nvidia e adicionar suporte a NVLink 4.0.
O processador no LPX de primeira geração nem sequer vem da Nvidia; embora a empresa tenha recusado-se a divulgar o hardware, racks vistos pela DCD parecem incluir chips AMD Epyc.
Em algum momento, é provável que a Nvidia migre para sua própria linha de CPUs, que será atualizada este ano com a CPU Vera.
Assim como a LPU, ela é afinada à idade agêntica.
"O futuro está começando a parecer um pouco mais agente, em que as IAs conversam com as IAs", diz Buck. "LLMs são IAs falando com humanos; só tirávamos humanos do circuito; então, basicamente, é a velocidade com que esse agente consegue se comunicar com esse agente. Não é limitado pela percepção humana."
A Nvidia entrou no cenário de CPUs de data centers em 2023 com o chip Grace, baseado nos núcleos Arm Neoverse. O chip, anunciado pela primeira vez em 2021, antecede a maior parte do boom da IA, sem falar na atual febre de agente.
"Acontece que a carga de trabalho necessária para se conectar a uma GPU é muito semelhante à que o agente precisa", diz Buck. "Há processamento inicial de KV, processamento de dados e, claro, núcleos rápidos, porque não queríamos que essas GPUs fossem lentas."
Ele aponta para a Lei de Amdahl, segundo a qual a velocidade máxima teórica de um sistema é limitada pela parte da tarefa não paralelizável. O Grace foi desenvolvido simplesmente para garantir que a GPU Blackwell atingisse todo o seu potencial.
"Temos que garantir que sempre desejamos alcançar o desempenho de CPU single-thread o mais alto possível, para manter a GPU ocupada."
O CEO Huang acrescenta: "IA não é sobre núcleos, é sobre trabalho. Quando você tem 50 bilhões de dólares (253 bilhões de reais) em GPUs ali, certamente não vai deixar essas GPUs ociosas enquanto 1 bilhão de dólares (5,6 bilhões de reais) em CPUs fazem seu trabalho.
"Você tem que terminar o trabalho das CPUs o mais rápido possível para que os 50 bilhões de dólares em GPUs nunca fiquem parados. Isso significa que nossos requisitos de CPU são substancialmente diferentes. E, como resultado, criamos CPUs muito diferentes."
Mas o que aconteceu foi que os clientes começaram a usar CPUs Grace cada vez mais, inclusive como gerenciador de cache KV em memória em toda a frota de computação. "Então, por exemplo, para inferência, sua consulta chega; sua memória KV foi fragmentada em vários nós para que possam agendar qual GPU atenderá sua próxima consulta de LLM", diz Buck. "E aí, conforme você atualiza, eles mantêm esse banco de dados ativo e sincronizam todos os caches KV."
A Meta foi a primeira empresa a anunciar publicamente que estava usando tanto o Grace conectado a uma GPU quanto um sistema independente, mas a DCD entende que outras empresas também estão implantando CPUs Nvidia independentes.
Com a próxima Vera, a Nvidia está mirando esse mercado de forma mais agressiva. "Este é nosso próximo negócio bilionário", diz Buck.
"Agora posso fazer trabalho agêntico na CPU", ele diz. "É por isso que você está vendo essa explosão na CPU."
Apesar da explosão, que ajudou a impulsionar os preços das ações da Intel e da AMD, a Buck chama as CPUs de "um mercado negligenciado."
Ele acrescenta: "Ficou entediante porque as pessoas simplesmente estavam construindo outro processador com mais núcleos e mirando em dólares por núcleo. Você nunca ouve falar de desempenho. Você sempre ouve falar de dólar por núcleo, dólar por núcleo. Como resultado, a engenharia desses processadores de data center evoluiu a ponto de deixar de valorizar a melhoria de desempenho."
O oposto aconteceu no mundo dos PCs, onde todo o foco estava no desempenho e em poucos núcleos. "Infelizmente, não vai funcionar para agentes que querem muitos núcleos e todos eles rápidos."
Vera possui 88 núcleos, notavelmente menos do que muitos de seus concorrentes em data centers. "Menos núcleos, mas os núcleos são mais rápidos, e o tecido que conecta todos esses núcleos é muito mais resistente", Buck contesta. "Ele tem três vezes a largura de banda de memória por núcleo do que o x86 e duas vezes mais eficiência energética."
Até o final do ano, a Nvidia espera lançar a Vera – junto com a nova GPU Rubin e a LPU Groq.
"Éramos uma empresa de GPUs", lembra Buck. "Depois, adquirimos a Mellanox e nos tornamos uma GPU mais NV Switch, mais Spectrum, Quantum, CX e assim por diante. E agora mais Bluefield, Grace e LPU.
"Você não pode atender todo o mercado de IA sem os sete chips e os cinco racks diferentes. A amplitude está se expandindo; os modelos só estão ficando maiores. Todas as diferentes modalidades de IA ainda estão acontecendo."
Huang também olhou para o passado. "Começamos com o Riva 128", ele diz, convenientemente ignorando o NV1 menos bem-sucedido que veio antes. "Tínhamos apenas um produto; agora temos 5050, 5060 e 5090, e todo tipo de produto. Não é diferente do começo do iPhone; agora existem tantas versões.
"Temos clientes com necessidades e faixas de preço diferentes, etc. Então temos desenvolvido esse espectro."



Comments