
Dos veces al año, el proyecto Top500 elabora una clasificación de los superordenadores más potentes del mundo. Esta competición para frikis amplía los límites de lo que un ordenador es capaz de hacer.
Es fácil fijarse en los primeros puestos de las listas para ver qué marca de GPU está impulsando algunas de las cargas de trabajo informáticas más intensivas jamás conocidas por el hombre. Pero hay un componente que a menudo se pasa por alto y que es el verdadero motor de rendimiento detrás de estas impresionantes hazañas de ingeniería.
La interconectividad, que une las distintas GPU entre sí, es la verdadera maravilla de la supercomputación. Es capaz de trasladar cargas de trabajo de un chip a otro a velocidades de vértigo, al tiempo que garantiza que los datos transmitidos permanezcan intactos.
Y aunque la lista Top500 enfrenta a los superordenadores entre sí, hay una segunda batalla que se ha estado librando: ¿deberían los clústeres utilizar Ethernet o InfiniBand?
Es un debate que lleva más de dos décadas en marcha, en el que cada uno se disputa el control del otro en constantes altibajos por el dominio, de forma similar a los pilotos de Fórmula 1 que se disputan los puestos del podio.
DCD se reunió con Mike Vildibill, vicepresidente y director general de redes de alto rendimiento Slingshot en Hewlett Packard Enterprise (HPE), para analizar cómo se está configurando el panorama de la interconectividad en la actualidad y qué protocolo podría imponerse en la era de la IA.
Ethernet frente a InfiniBand: ¿cuál es la diferencia?
Ethernet, la base de las redes modernas basadas en el Protocolo de Internet (IP), es posiblemente el protocolo de Internet más definido y comprendido.
Los dispositivos conectados en una LAN (red de área local) o WAN cableada utilizan Ethernet para comunicarse entre sí. En el mundo de la supercomputación, Ethernet hace lo mismo, permitiendo que las GPU interconectadas se transmitan datos entre sí mediante un clúster (lo que se conoce como «scale up»), o que clústeres enteros se comuniquen entre sí de una instalación a otra (lo que se conoce como «scale out»).
InfiniBand, su protocolo de interconexión rival, hace lo mismo, aunque, a diferencia de Ethernet, se trata de una oferta en gran medida propietaria. Aunque técnicamente es un estándar abierto, Nvidia controla el ecosistema, y en realidad solo se encuentra en las soluciones de red del gigante de las GPU. Nvidia adquirió Mellanox, líder en InfiniBand, en 2020 para consolidar aún más su dominio.
Por lo tanto, los usuarios de InfiniBand pueden aprovechar todas las ofertas de la pila de software CUDA de Nvidia, que está profundamente integrada con el protocolo, lo que brinda a los operadores de superordenadores acceso a un ecosistema maduro.
Ahí radica la diferencia. Ethernet es abierto, lo que significa que los ingenieros de centros de datos y superordenadores pueden interconectar fácilmente cientos de GPU y otro hardware de múltiples proveedores, ya sea AMD, Intel o incluso Nvidia (con su nueva estructura Spectrum-X, que se basa en Ethernet, alejándose de su norma habitual).
Dada su mayor disponibilidad entre los proveedores, Ethernet resulta familiar para la gran mayoría de los ingenieros de todo el sector.
InfiniBand, sin embargo, ha ofrecido históricamente un rendimiento superior para cargas de trabajo de HPC, especialmente en escenarios de latencia ultrabaja. Esto se debe a la inclusión nativa del acceso directo a memoria remota (RDMA), con adaptadores de red capaces de transferir datos directamente entre la memoria de diferentes sistemas, eludiendo por completo la CPU y eliminando las sobrecargas de procesamiento que, de otro modo, añadirían latencia.
Ethernet encuentra su camino
Dado su alto rendimiento, junto con la demanda del sector por el hardware de Nvidia, no es de extrañar que InfiniBand llegara a dominar el panorama de las redes de IA. A finales de 2023, el protocolo aún tenía una cuota de mercado de alrededor del 80 %.
Pero donde antes reinaba InfiniBand, lenta pero seguramente, Ethernet ha encontrado su camino. Y en ningún ámbito ha tenido más éxito que en el mundo de la supercomputación, donde la interconexión Slingshot basada en Ethernet de HPE se encuentra entre los principales contendientes.
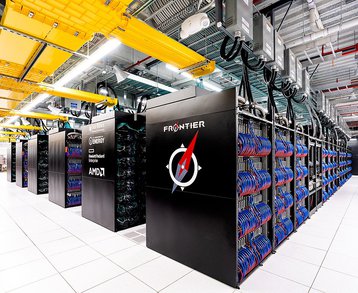
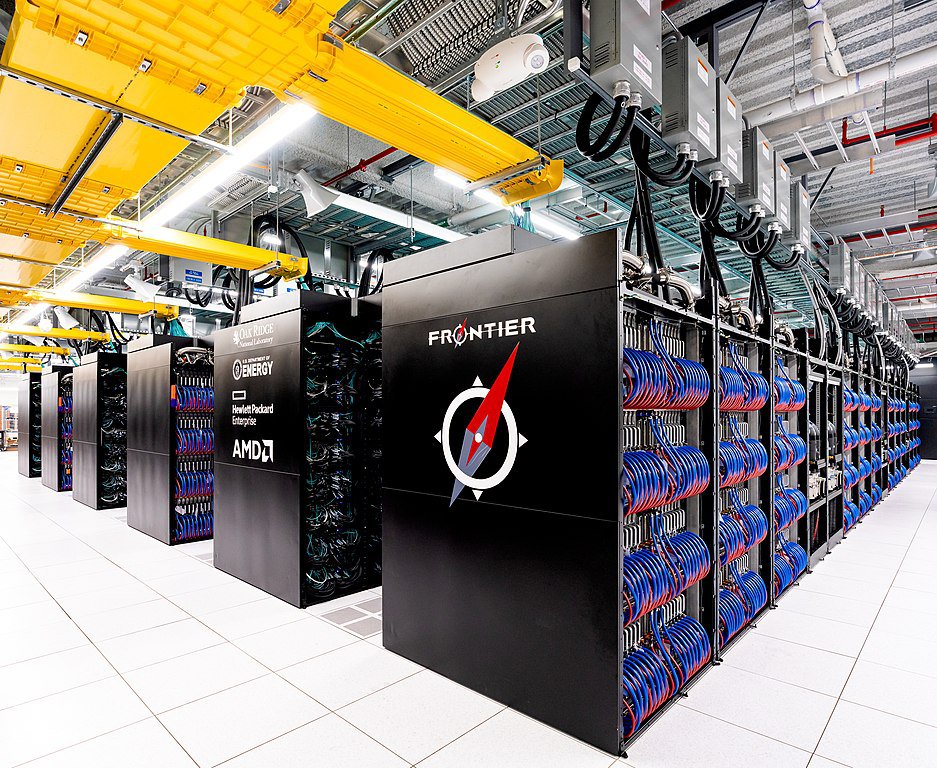
En la última lista, de junio de 2025, seis de los diez ordenadores más potentes del mundo utilizan Slingshot de HPE, incluidos los tres primeros: El Capitan, Frontier y Aurora. Ese dominio se extiende a los 30 primeros, con un total de 12 sistemas que utilizan Slingshot.
InfiniBand es el sistema de interconexión con mayor cuota de mercado de la lista, ya que 189 de los sistemas del Top500 utilizan InfiniBand NDR200. Sin embargo, en términos de rendimiento, Slingshot 11, la última y más avanzada solución de interconexión de HPE, alcanzó una cuota de rendimiento del 48,1 %, frente al 28,8 % de InfiniBand NDR200.
Y Ethernet tampoco da señales de ralentizarse: según un estudio reciente de Dell’Oro Group, se prevé que Ethernet domine el espacio de la estructura a escala de centro de datos en los próximos años, lo que contribuirá a generar casi 80 000 millones de dólares en ventas de conmutadores para centros de datos durante la próxima media década, a medida que los operadores se apresuran a buscar una alternativa abierta a InfiniBand.
El último sistema en adoptar lo que Mike Vildibill y el equipo de HPE describen como «Ethernet plus» o «Ethernet con un toque especial» fue Isambard-AI, el superordenador más rápido del Reino Unido. Inaugurado en el verano de 2025, se aupó directamente al puesto 11 de la lista Top500 en junio, con Slingshot proporcionando 25,6 Tbps de ancho de banda bidireccional a través de 64 puertos, cada uno con capacidad para 200G.
El vicepresidente de HPE explica que el secreto del éxito de Slingshot reside en conseguir que la tecnología «funcione como una interconexión propietaria en el interior y como Ethernet en los extremos».
«Intentamos continuar el legado de lo que hizo Cray tras ser adquirida por HPE», afirma Vildibill, refiriéndose a Cray Research, la empresa pionera en supercomputación que HPE compró en 2019.
Vildibill continúa: «Creían que podían implementar una interconexión compatible con Ethernet y que cumpliera con los requisitos en los extremos, al tiempo que seguía realizando parte del trabajo altamente especializado dentro de la estructura, o el ingrediente secreto. Lo consiguieron, y queremos continuar con eso».
Avanzando a pasos agigantados
Dado que se prevé que Ethernet domine entonces, ¿qué nos depara el futuro? Cooperación y escala, si hay que creer en los movimientos del sector.
En primer lugar, está el ESUN, el nuevo grupo de trabajo del Open Compute Project centrado en las redes y destinado a explorar Ethernet para la ampliación de la IA. HPE se une a empresas como AMD, Meta y Microsoft en un proyecto destinado a examinar conmutadores de red basados en Ethernet, con el objetivo de crear potencialmente una conmutación Ethernet abierta y basada en estándares para cargas de trabajo de IA.
Pero lo más significativo de todo, quizás, sea el Ultra Ethernet Consortium (UEC), que pretende llevar las redes Ethernet al siguiente nivel. Su especificación 1.0 incorpora a Ethernet la codiciada compatibilidad con RDMA de InfiniBand, lo que proporciona un transporte de baja latencia para entornos de alto rendimiento, al tiempo que garantiza la interoperabilidad que ha hecho que Ethernet tenga tanto éxito. Y es un proyecto al que HPE está apoyando con todo su peso.
«El UEC está avanzando para definir lo que es, en esencia, Ethernet Plus, como un estándar industrial abierto. La industria quiere construir [y] hacer exactamente lo que hemos hecho con Slingshot», explica Vildibill. «No solo apoyamos la iniciativa del sector, sino que somos miembros fundadores de la UEC. Hemos aportado una gran cantidad de propiedad intelectual basada en Slingshot, y acogemos con gran satisfacción una estandarización del sector en torno a algo que se acerca más a Slingshot que el Ethernet actual».
A pesar de tener menos de un año de antigüedad, Vildibill explica a DCD que hasta un 70 % de la especificación de transporte de la UEC proviene de Slingshot.
«No competimos con la UEC, la acogemos con los brazos abiertos, porque impulsa lo que nosotros también intentamos hacer, que es llevar Ethernet a todas partes».
Forjado a gran escala
Lo que distingue a Slingshot no son solo sus especificaciones técnicas, sino cómo se han puesto a prueba esas capacidades en la práctica. A diferencia de la mayoría de los productos de red que empiezan a pequeña escala y luego se amplían, el enfoque de HPE fue, como admite Vildibill, hacer las cosas por el camino difícil.
«Cray desarrolló una nueva interconexión, y sus primeras implementaciones, para las que la habían diseñado —y que HPE entregó tras la adquisición de Cray—, fueron los sistemas más grandes del mundo, más grandes que nunca», afirma Vildibill. «Nos encontrábamos con problemas que nadie había experimentado jamás».
A una escala extrema, incluso los problemas más pequeños se vuelven críticos, como explica el vicepresidente: «Cuando estás ejecutando algo en 100 000 nodos y tienes una tasa de fallos de uno entre 10 millones, eso va a ocurrir en unos 10 segundos».
Esto obligó al equipo a eliminar casos extremos y errores que serían insignificantes a escalas más pequeñas, pero que se convertían en obstáculos insuperables cuando se amplificaban a través de cientos de miles de nodos.
¿Cuál fue el resultado de este riguroso proceso de selección? Sistemas líderes a nivel mundial que aprovechan un producto perfeccionado primero en el segmento de gama alta.
«Su fiabilidad, resiliencia, tasa de errores y tasa de fallos son extraordinariamente bajas porque, si conseguimos que estas cosas no ocurran a gran escala, entonces es muy raro, por no decir imposible, que ocurran a pequeña escala», concluye Vildibill.
Comments