
As pinceladas gerais sobre como construir um ótimo cluster de treinamento de IA estão bem estabelecidas: reúna o máximo de GPUs que puder, empacote-as densamente com rede rápida e bombeie o máximo de dados possível.
Mas, à medida que a IA se prepara para entrar em sua era de inferência, a aparência de um data center construído para esse desafio é um grande debate.
Algumas abordagens de modelo de IA generativa optaram por destilar o modelo em sua menor forma para que ele possa caber em um dispositivo como um telefone, eliminando a necessidade de interagir com um data center e apenas enviando solicitações mais complexas, bem como dados para treinamento futuro.
Outros se encaixam em GPUs únicas ou racks parciais, com as empresas esperando que a maré crescente de IA ajude a fornecer ao Edge seu aplicativo matador tão necessário.
Mas para o vice-presidente sênior de redes da Nvidia, Kevin Deierling, a adoção de modelos de raciocínio pela indústria de IA generativa aponta para uma abordagem diferente de inferência – que se parece muito com os clusters de treinamento compactos de hoje.
"Não tenho certeza se a [indústria de data center] entende totalmente o impacto dos modelos de raciocínio", diz ele à DCD. "Certamente existem cargas de trabalho de IA, como robôs ou carros [autônomos], que precisam absolutamente da inferência mais rápida e, portanto, precisam estar próximas de onde quer que isso esteja acontecendo. Para essas cargas de trabalho, com certeza será na borda ou no dispositivo, e pode ser uma computação relativamente pequena e, em seguida, muitas delas em todo o lugar".
Mas, para os grandes modelos de raciocínio, isso exigirá uma escala significativa.
A Nvidia, que obviamente se beneficia de uma necessidade crescente de escala cada vez maior, acredita que o mercado de IA generativa evoluiu para três fases de carga de trabalho.
A primeira é a fase de pré-treinamento, "onde treinamos modelos de fundação", diz Deierling. A partir daí, passamos para o "pós-treinamento, onde os modelos vão pensar", continua ele. "Então, ensine seus modelos a pensar: você começa com 20 petabytes de dados e depois passa para centenas de petabytes de dados, ou até um trilhão em termos de parâmetros do modelo. Podemos até pós-treinar modelos multimídia com visualização e, portanto, tudo isso está expandindo a escala".
Mas a fase mais interessante vem a seguir. Conhecido como escalonamento de tempo de teste, ele essencialmente dedica substancialmente mais recursos computacionais durante a fase de inferência para melhorar o desempenho. O modelo pode simular vários caminhos ou respostas de solução e selecionar o melhor, pois raciocina uma resposta.
"O que é interessante é que estamos passando da inferência única, onde você faz uma pergunta e imediatamente lhe dá uma resposta de um modelo de base pré-treinado para esses modelos de raciocínio", explica Deierling.
"O modelo de raciocínio descobre isso, ele pensa nos tokens. E o ponto é que a quantidade de computação para inferência é enorme. Mesmo os modelos 'menores' de que estamos falando - 671 bilhões de parâmetros para o DeepSeek R1, é um modelo enorme, não cabe em uma única GPU. É preciso uma dúzia de GPUs".
Quando isso é usado para raciocínio agêntico, em que cada agente tem seu próprio banco de dados de informações e conclui tarefas complexas de forma autônoma (como usado no Deep Research da OpenAI), o requisito de GPU cresce cada vez mais.
"Vemos a escala da inferência como algo que as pessoas não haviam previsto", diz Deierling. "Mesmo um ano atrás, na Nvidia, eu estava meio que travando essa batalha que as pessoas diziam: 'oh, vai ser um tiro, um único nodo: faça a inferência, obtenha uma resposta'. E estamos vendo que não é absolutamente o caso".
Isso, ele afirma, já é a direção em que os maiores clientes de IA da Nvidia estão se movendo. "Eles constroem clusters de treinamento, que são de escala muito, muito grande, mas isso está no lado das despesas de sua demonstração de resultados. A inferência está do lado da receita, é aí que eles ganham dinheiro.
"Então, havia essa ideia de que você teria um cluster de treinamento e depois um cluster de inferência, mas não vemos isso no campo. O que vemos é que eles constroem um cluster gigante que foi construído para treinar seus modelos de fundação, e então eles pegam tudo ou parte disso e começam a usá-lo para inferência”.
No início, diz ele, as pessoas pensaram que "isso seria um exagero, não precisamos de rede para inferência, podemos apenas executá-la em caixas individuais", mas, diz ele, "acontece que a inferência precisa de uma tonelada de rede por todos os tipos de razões".
Agora, ele acredita: "Vamos ver clusters de treinamento usados para inferência".
Isso, é claro, significa que os data centers de inferência cada vez maiores enfrentarão o mesmo problema que os de treinamento - o de energia.
"Se tivermos 100.000 GPUs, ou um milhão, escalando para inferência, temos que realmente prestar atenção ao orçamento de energia", diz Deierling. "Então é aí que entra o CPO, na verdade está fornecendo um enorme benefício de energia".
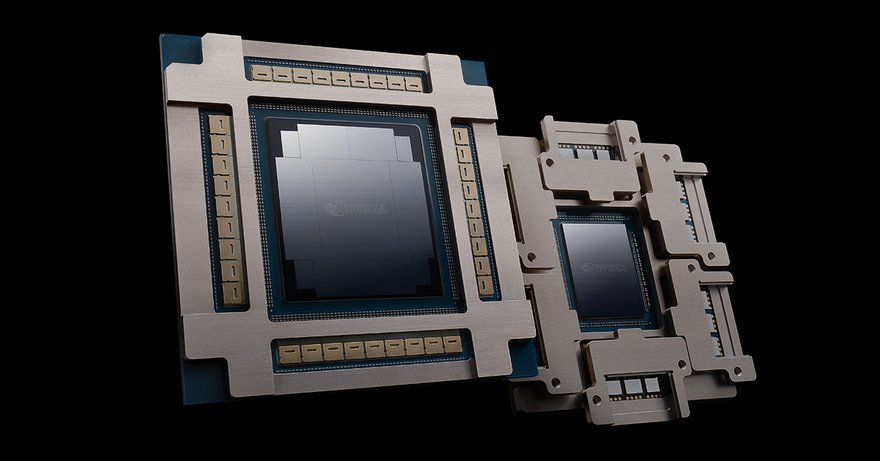
Anunciados no início deste ano, os switches ópticos empacotados conjuntamente (CPO) da Nvidia com fotônica de silício integrada são projetados para reduzir radicalmente as demandas de energia do equipamento de rede - convenientemente abrindo mais capacidade para mais GPUs.
"O que descobrimos é que alguns de nossos clientes têm muito dinheiro", diz Deierling, descrevendo um problema que outras empresas adorariam ter. "Eles podem comprar mais coisas, mas a restrição é, na verdade, esse orçamento de energia".
Why we acquired SDxCentral
We’re getting bigger - here’s what that means for you
Enquanto a indústria está em busca de mais locais com energia e está investindo dinheiro em infraestrutura de energia, o CPO pretende fazer mais com o que está disponível. "Na medida em que podemos economizar 30 ou 50% da energia de interconexão passando da óptica tradicional para o CPO, essa é a força motriz", diz Deierling. "Estamos falando de 10 megawatts de economia de energia em um data center gigante".
Um benefício de segunda ordem é que ele deve aumentar a confiabilidade, acredita a Nvidia. Gilad Shainer, vice-presidente sênior de rede da Deierling, explica: "Em cada GPU que você coloca em um data center, você precisa instalar seis transceptores. Portanto, o número de componentes no data center está crescendo muito rápido e, obviamente, quanto mais componentes você tiver, mais coisas poderão falhar com o tempo".
Os componentes que falharem precisarão ser substituídos, mas isso também representa um risco. "Por exemplo, quando você substitui um transceptor, uma das falhas que você tem como humano é que seus dedos têm uma dimensão", diz Shainer. "Quando você coloca um transceptor em uma infraestrutura de computação muito densa, você toca em outros transceptores e, quando toca em outras coisas, pode realmente criar problemas em outros elementos".
Com o CPO, o transceptor externo é movido para dentro do próprio pacote, reduzindo o número de lasers em quatro vezes. "Portanto, existem centenas de milhares de transceptores que agora não são necessários".
Ele acrescenta: "Você reduz o toque humano, reduz drasticamente o número de componentes, aumenta a resiliência e pode aumentar a capacidade total porque reduz o consumo de energia".
Por enquanto, as ambições de fotônica de silício da Nvidia estão diretamente no nível do switch para comunicações rack a rack. "Faremos cobre o máximo que pudermos [dentro do rack] com NVLink e aumentaremos a escala", diz Deierling. "Em algum momento no futuro, você pode imaginar que tudo se tornará óptico".
Entre as interconexões ópticas do data center, os data centers já estão se comunicando entre si para execuções de treinamento multicluster.
"O que vemos é que, nos maiores data centers do mundo, há na verdade um data center e outro data center e outro data center", diz ele. "Então a discussão interessante se torna - eu preciso de 100 metros? Preciso de 500 metros? Preciso de uma interconexão de quilômetro entre os data centers?".
Deierling não arrisca dizer qual é esse limite, embora a velocidade da luz seja o limitador final para escalas de treinamento e inferência.
Para inferência, a latência geralmente é dada como um motivo para manter as GPUs próximas ao usuário. "Mas se houver 200 milissegundos de latência, nem percebemos", diz Deierling, minimizando as preocupações. "Os humanos não percebem isso".
O que importa é para as cargas de trabalho agentes, onde as IAs conversam com as IAs. "Precisamos de latências abaixo de um milissegundo, conectividade de rede entre os dispositivos", diz ele, o que pode acontecer dentro da mesma instalação.
"Esse último salto de um data center centralizado pode ser um pouco importante", diz ele. Você não pode compor isso.
"Não posso ter um fluxo de trabalho agencial de inferência que vai e volta da Califórnia para Nova York uma dúzia de vezes porque essa latência aumenta. Portanto, acho que as cargas de trabalho de inferência agêntica acontecerão em um data center centralizado, mas podemos lidar com um salto para um usuário e viver com isso".


Comments