
O nascimento da IA generativa gerou uma nova geração de provedores de computação, que, em sua maioria, aproveitam o acesso às GPUs da Nvidia para oferecer serviços de neocloud mais rápidos e baratos do que os dos gigantes da hiperescala.
Empresas como CoreWeave, Nebius e Iren aproveitaram essa onda com grande sucesso e agora são grandes provedoras de nuvem por conta própria, enfrentando os mesmos desafios de manter um enorme portfólio de data centers.
Com a IA agente agora apresentada como a próxima evolução da era generativa, novos provedores de chips e empresas de nuvem presumíveis esperam, mais uma vez, remodelar o mercado, com foco na inferência de baixa latência próxima ao cliente final.
Este artigo foi publicado no início do ano no suplemento Agentic AI. Leia gratuitamente hoje mesmo.
Um desses esforços é o Vector Core Compute (VC2), uma curiosa combinação de private equity e computação inovadora que espera provar que o Edge finalmente encontrou seu aplicativo assassino na IA agêntica. Apoiados pela Vista Equity Partners e pela Cambium Capital e usando hardware da SambaNova, conversamos com a empresa para sua primeira entrevista exclusiva.
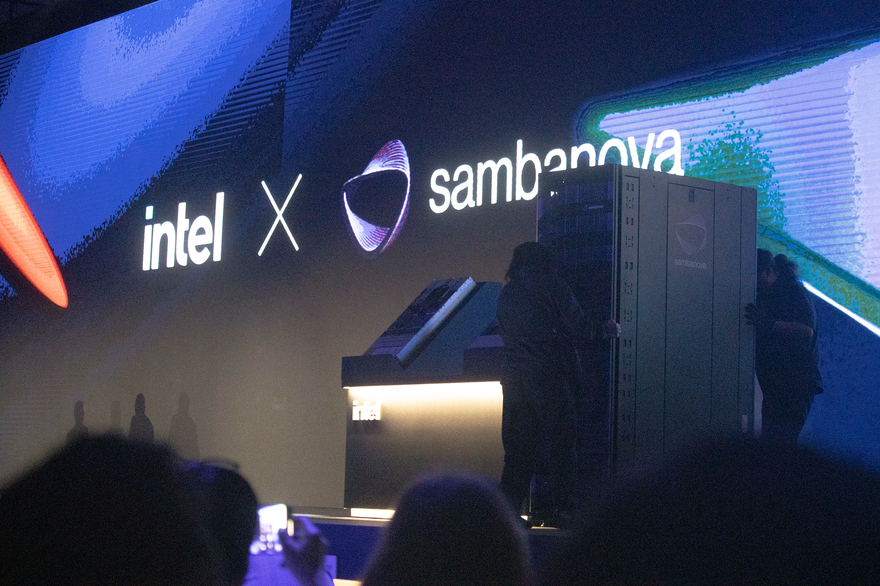
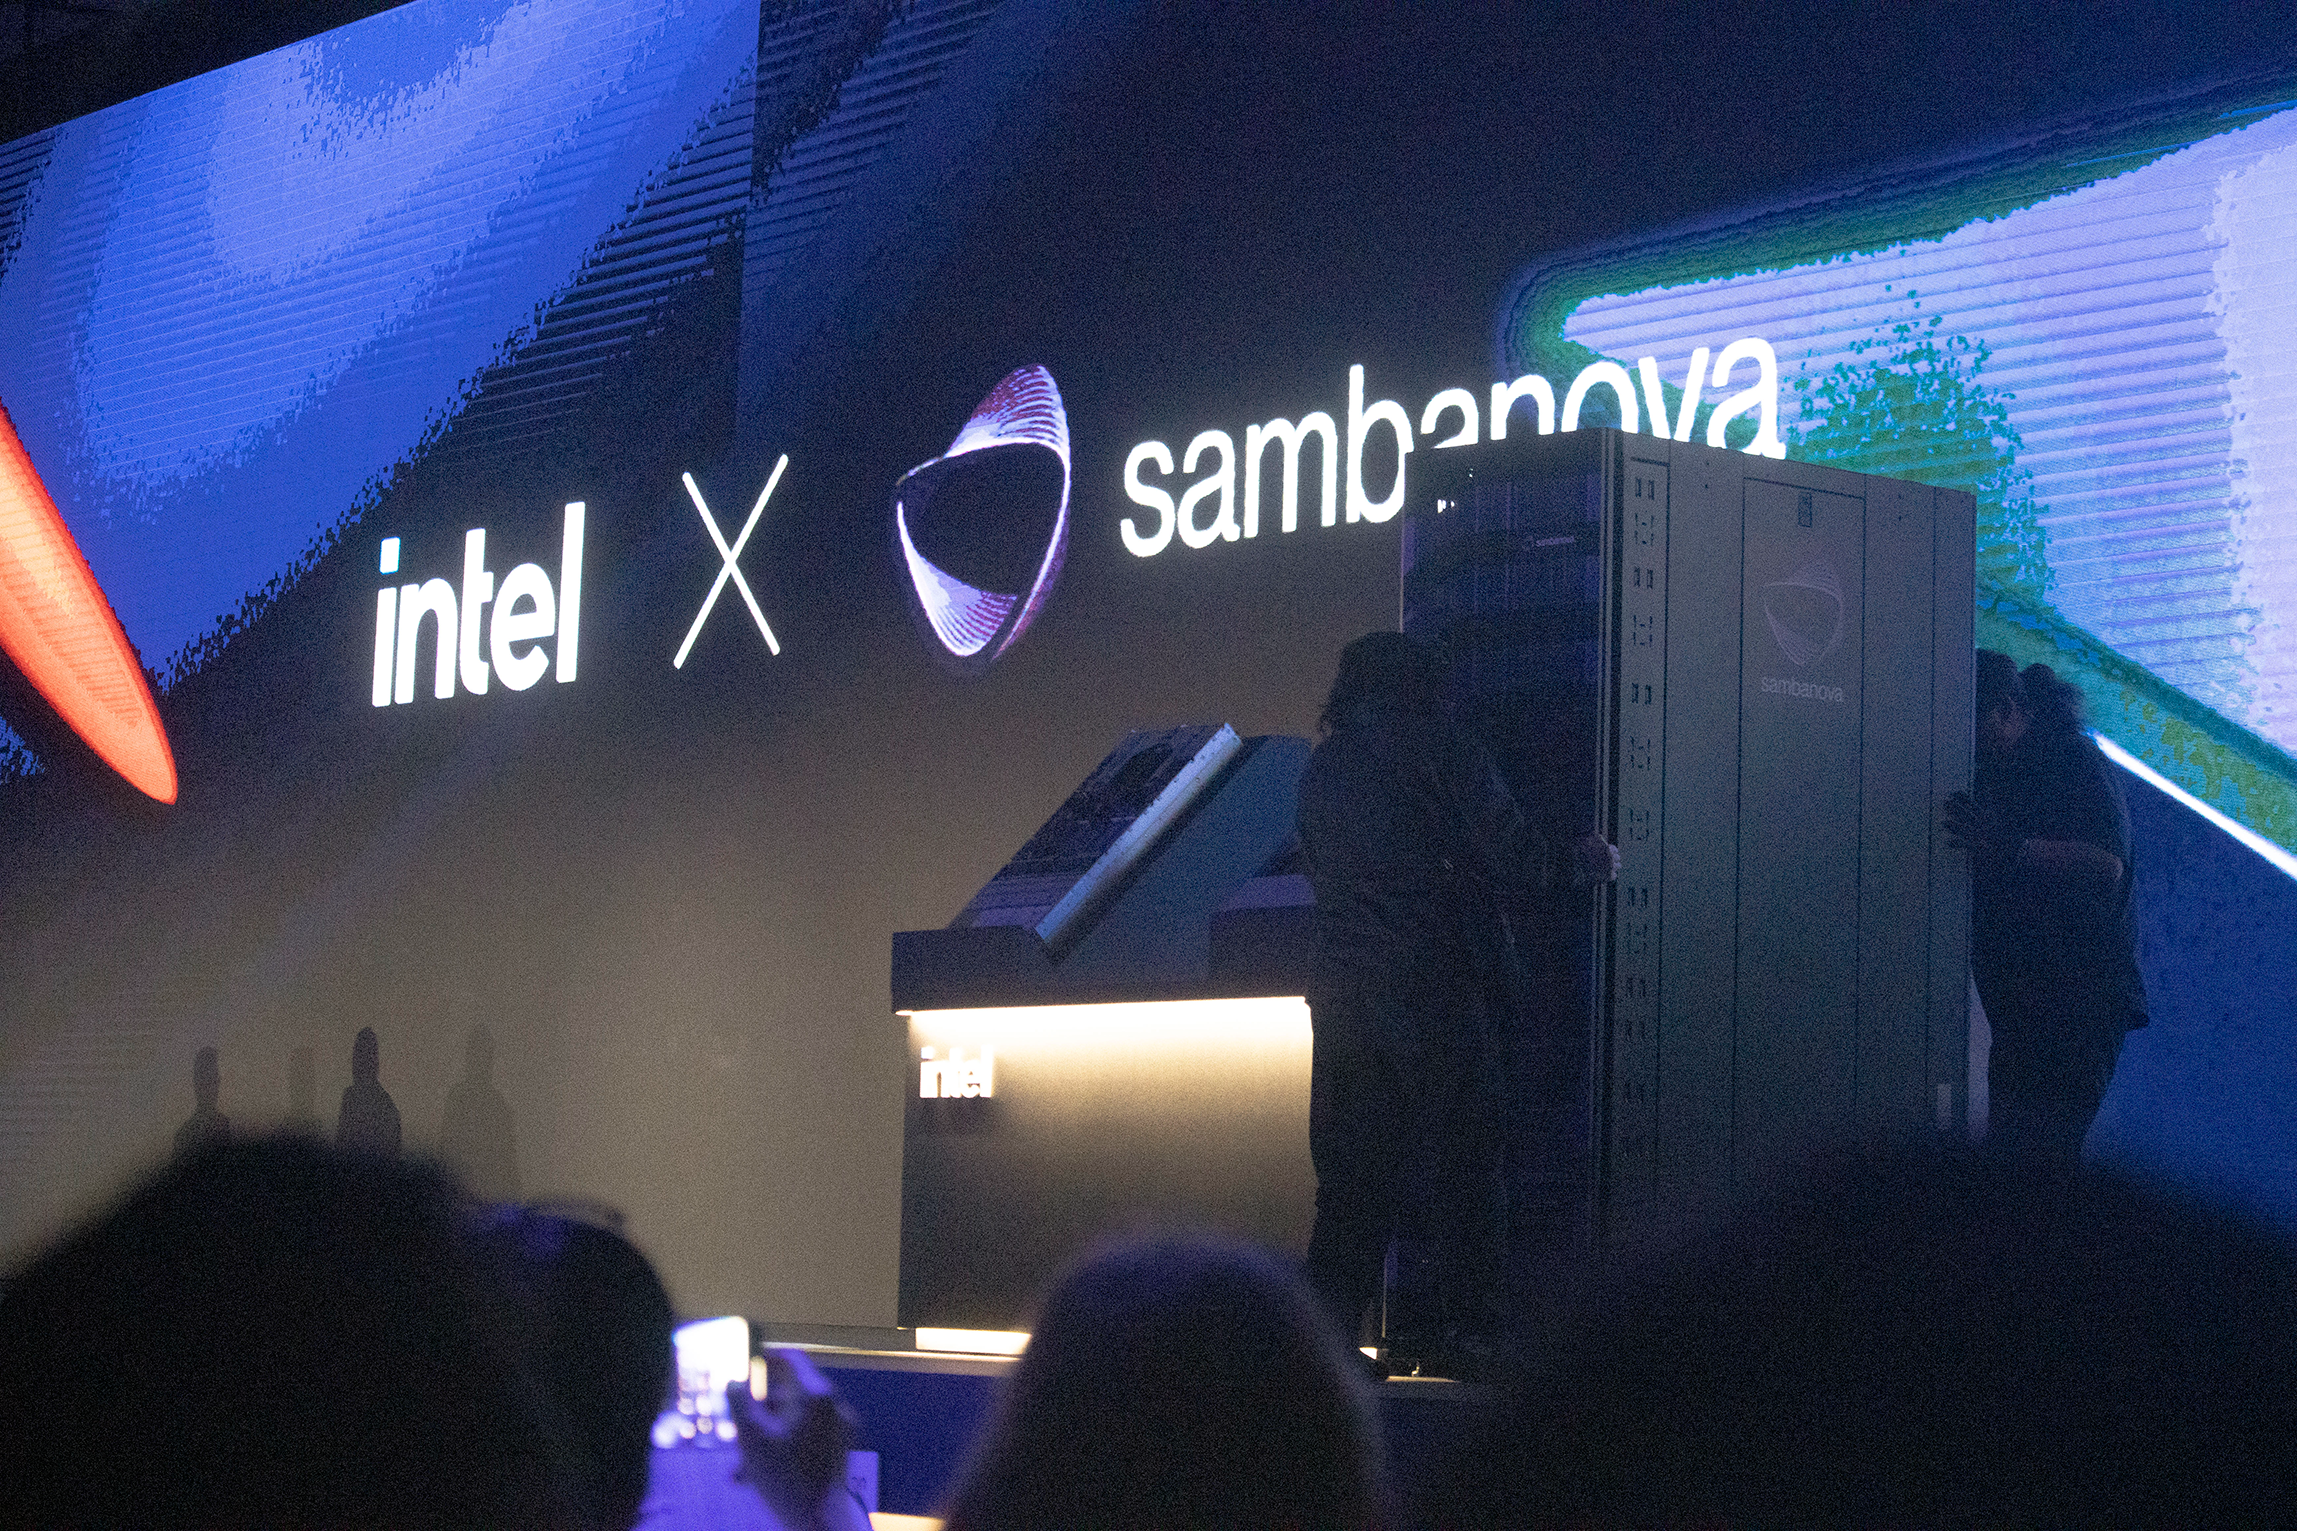
A VC2 se comprometeu a investir cerca de 3,5 bilhões de dólares ao longo de três anos na SambaNova, uma provedora de computação que projeta seus próprios chips de Unidade de Dados Reconfigurável (RDU), que ela integra a uma plataforma mais ampla que inclui hardware da Intel.
Tanto a Vista quanto a Cambium já eram investidoras da SambaNova, mas dizem que viram uma oportunidade de avançar mais abaixo na cadeia e fornecer processamento aos clientes – alguns dos quais também investiram.
"A Cambium é uma empresa de capital de risco em estágio inicial que investe em empresas que avançam na computação, então trabalhamos principalmente com empresas de hardware – como Groq, Rivos, Samba e afins", explica Landon Downs, cofundador e sócio-gerente da Cambium.
"Achamos que esses investimentos são ótimos para data centers e, dado o rumo do mundo, decidimos que deveríamos realmente começar a construir data centers nós mesmos."
Ao mesmo tempo, o Vista estava percebendo uma mudança em seus investimentos, que historicamente eram concentrados principalmente no setor de software. Seus negócios do portfólio estavam gastando cada vez mais com IA agêntica ou desenvolvendo sua própria IA agente.
"Verticalizando os casos de uso da empresa até a pilha de hardware. Você acaba com uma solução superior em nossa mente porque intencionalmente constrói a pilha para que possamos atender à empresa, e essa foi meio que a gênese disso", diz Downs.
Enquanto grande parte do mercado tem se deslocado para buscar implantações cada vez maiores, Downs diz que sua experiência com uma propriedade no Canadá lhe ensinou que "você não acaba necessariamente com economias de escala quando está construindo megaprojetos de grande escala.
"Em alguns casos, você realmente obtém uma economia significativamente maior ao realizar projetos de menor escala; por isso, estamos focando em data centers de baixo custo, baixa latência e alto desempenho."
Downs acredita que, com o hardware certo próximo o suficiente dos centros urbanos, "você pode ter o processamento próximo de onde realmente quer consumi-lo. Os data centers terão muita inferência, mas também pensem nisso como capacidades de refinamento e treinamento, além de armazenamento na Edge, para que você possa executar inferência de baixa latência onde quiser. Você também poderia coletar e armazenar dados e realizar treinamento de refinamento em um só lugar, o que poderia ser feito em economias que funcionem melhor para clientes corporativos."
O resultado dessas crenças simultâneas é um plano para se espalhar por até 50 centros metropolitanos nos EUA, elevando rapidamente a VC2 aos escalões superiores dos provedores de Edge da América do Norte.
"Serão data centers de 5 a 20 MW e ajudarão a criar esse tecido de latência ultra-baixa", diz Downs. "Estamos encontrando locais que atendam a um conjunto de critérios, firmando um contrato de locação do espaço e, em seguida, trabalhando com o proprietário para implementar as atualizações necessárias para atender às especificações do data center. Para alguns deles, podem ser sites de data center anteriores; para outros, podem não ser estruturados como data centers, mas sim como edifícios com as especificações corretas."
Cerca de dez locais estão "muito próximos de estarem prontos para operar", com uma instalação em Los Angeles já em funcionamento.
"LA foi escolhida por sua localização devido à alta intensidade de processamento e aos requisitos de modelos multimodais, já que LA tem alta propensão a vídeo e a todo tipo de coisa parecida", diz Downs, recusando-se a compartilhar a localização exata.
Este primeiro data center VC2 "tem capacidade para ser um local de 10 MW", mas, atualmente, é menor. "E teremos muitos racks em breve em um segundo prédio em LA, Chicago, Seattle e Columbus", diz Downs.
Nesta primeira fase, o local da SambaNova abrigará cerca de 40 racks da SambaNova, revela o vice-presidente de produto da empresa, Anton McGonnell. No momento, eles estão usando a RDU SN40, mas estão programados para lançar a próxima, a SN50, ainda este ano.
"Esse é o nosso sistema de próxima geração, o que é muito, muito empolgante para nós, porque acreditamos que vamos dominar o mercado de decodificação rápida em modelos grandes. Acreditamos que somos intocáveis lá", diz McGonnell.
Para LLMs e modelos similares, a inferência geralmente é dividida em duas partes. A primeira é o preenchimento, em que os tokens do prompt são processados em paralelo para construir o cache de atenção chave-valor. Depois vem o decod, em que a resposta é gerada auto-regressivamente, um token de cada vez.
Apesar de todo o discurso sobre romper o domínio da Nvidia, até mesmo a SambaNova precisa ceder ao gigante das GPUs em parte do desafio de inferência. O VC2 está prestes a coimplantar SambaRacks junto com as GPUs Nvidia Blackwell, com foco na etapa de pré-preenchimento. Enquanto isso, CPUs Intel Xeon serão usadas para orquestração e execução, com a Intel sendo uma investidora proeminente na SambaNova.
"A SN50 também é uma boa máquina pré-preenchida", argumenta McGonnell. "Mas chegamos à conclusão de que as GPUs já têm uma base de instalação enorme e são máquinas de preenchimento incrivelmente boas. Com a computação crunch, quanto mais pudermos aliviar isso acelerando as GPUs, mais todo mundo sai ganhando."
Claro, a própria Nvidia está tentando se impor no espaço de latência ultrabaixa, com a quase aquisição do Groq e o lançamento iminente de sua Language Processor Unit (LPU).
"O que a Nvidia está tentando fazer com o Groq – mais por necessidade do que pelo design – é decodificar separadamente a atenção, rodando nas GPUs, e a FFN [Feed-Forward Network], onde a maioria dos pesos está, rodando nas LPUs para decodificação rápida. Acho que separar a FFN da atenção simplesmente não faz sentido por diversos motivos técnicos."
McGonnell também era cético em relação à Cerebras, a grande empresa de chips que recentemente abriu capital por cerca de 95 bilhões de dólares, mas que vem caindo de forma constante desde então. "A Cerebras ser sua própria nuvem, novamente, é por necessidade", ele diz.
"Os sistemas deles são muito, muito difíceis para qualquer outra pessoa implantar; são muito exóticos e exigem seu próprio sistema proprietário de resfriamento líquido. Nossos sistemas são refrigerados a ar e leves, cabem na grande maioria dos data centers existentes, e nossa pilha de software os torna altamente utilizáveis para operadores de nuvem ou de data centers. Não queremos construir nossa própria nuvem em grande escala; queremos vender racks e permitir que nossos parceiros façam isso."
É difícil validar essa crítica ao hardware da SambaNova devido às atuais limitações de implantação. Apesar de todo o discurso positivo, a empresa foi forçada a cancelar seu programa de treinamento e a demitir 15% de sua equipe no ano passado. Embora a Intel tenha apoiado o negócio, o plano de venda da empresa também estagnou.
The Agentic AI Supplement
From compute, to servers, to neocloud operations
No entanto, nos próximos meses, a SambaNova terá a chance de comprovar suas elevadas afirmações. O VC2 não é o único a implantar o SambaNova, com o concorrente recém-chegado, General Compute, lançando um serviço de inferência com múltiplos ASICs. No entanto, será de longe a maior implantação dessa tecnologia, que, até onde se sabe, é pouco comprovada.
O esforço já está pronto para potenciais clientes, com a Vista Equity oferecendo o projeto às suas 90+ empresas do portfólio, algumas das quais já o utilizaram antes do lançamento oficial. "Trata-se de garantir acesso à computação e computação de baixo custo para [nosso] portfólio, e esperamos usá-lo intensamente", diz Justin Hirsch, chefe de estratégia da Vista.
Refletindo a natureza cada vez mais interconectada das nuvens modernas, outro cliente é a neocloud Together AI. "Continuamos vendo uma demanda exponencial por tokens de inferência, agora atendendo a mais de 400 toneladas de tokens por mês de modelos abertos para casos de uso de agentes", disse o CEO da Together, Vipul Ved Prakash, no início deste ano.
"Não esperamos substituir a necessidade de alguém usar as nuvens existentes, mas sim ampliá-las", diz Downs.
À medida que as necessidades de tokens aumentam, ele acredita que as expectativas de latência mais baixa também aumentam. "Acreditamos que haverá um prêmio contínuo para tokens rápidos e de baixa latência. O que acontecerá com o tempo é que a expectativa sobre o que é um token de commodities, do ponto de vista da velocidade, simplesmente mudará.
"Em vez de serem 60 tokens por segundo agora, com o modo rápido, 2,5x isso, consigo ver o modo rápido hoje virando uma mercadoria, e o próximo passo é 400 tokens por segundo."
Comentários