
Frequentemente falamos sobre inteligência artificial (IA) e consumo de energia do data center através de uma lente macro.
As estatísticas são inegáveis, inevitáveis e francamente impressionantes. O relatório de outubro da Agência Internacional de Energia descobriu que o consumo global de eletricidade do data center "aumentaria significativamente" até 2030, citando os esforços de IA e digitalização como força motriz.
Em dezembro de 2024, o Departamento de Energia dos EUA descobriu que, embora os data centers consumissem cerca de 4,4% da energia do país em 2023, isso poderia aumentar para 12% até 2028 - enquanto a própria geração de energia também está crescendo.
A IA está disparando as demandas de energia dos data centers por dois motivos principais; as GPUs necessárias têm um alto consumo de energia e o treinamento de modelos de IA requer muitas dessas GPUs.
Embora a startup chinesa DeepSeek afirme ter treinado seu modelo usando muito menos hardware do que seus rivais no Ocidente, para a maioria das empresas, o desenvolvimento de IA continua sendo uma busca intensiva em recursos.
Mas dentro dos gigantescos números, os campi de gigawatts e as dezenas de milhares de GPUs por cluster são as minúcias: os microssegundos. O consumo de energia dentro do contexto do tempo.
As cargas de trabalho de IA - IA generativa e o treinamento de grandes modelos de linguagem em particular - exigem uma profusão de poder em apenas uma fração de segundo, e isso por si só traz algumas complicações.
"Quando você está engajando um modelo de treinamento, você envolve todas essas GPUs simultaneamente, e há um aumento muito rápido para praticamente a potência máxima, e estamos vendo isso em um ritmo inferior a um segundo", disse Ed Ansett, diretor da I3 Solutions, à DCD.
"O problema é que você tem, por exemplo, 50 MW de carga de TI que a concessionária está prestes a ver, mas ela verá muito rapidamente, e a concessionária não será capaz de responder tão rapidamente. Isso causará problemas de frequência e a concessionária quase certamente desconectará o data center, portanto, é necessário haver uma maneira de armazenar essas cargas de trabalho em buffer".
Em dezembro de 2024, o Lawrence Berkeley National Laboratory divulgou o Relatório de Uso de Energia do Data Center dos Estados Unidos de 2024, que analisou o pico de consumo de energia das cargas de trabalho de treinamento de IA.
Esse relatório explica que, embora as GPUs normalmente façam a maior parte da computação para cargas de trabalho de treinamento de IA, elas operam como parte de nós complexos, incluindo "unidades de processamento central (CPUs) de supervisão, memória e interconexão de alta largura de banda".
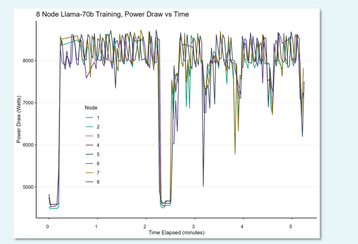
"Essa integração significa que componentes individuais podem limitar outros, criando perfis de carga característicos", diz o relatório. "As medições empíricas mostram consistentemente que, mesmo em cargas de trabalho computacionalmente intensivas, a demanda de energia no nível do nó raramente se aproxima dos máximos avaliados pelo fabricante".
O relatório prossegue observando que "a flutuação característica na demanda de energia para treinamento de IA em comparação com cargas de trabalho de HPC mais convencionais ... pode ser especialmente desgastante para os operadores da rede".
Há algumas nuances nisso, é claro, dependendo da concessionária e da região. É uma questão de escala - quão grande é o data center e quanto do consumo de energia da concessionária ele representa.
Mas as consequências do mundo real estão sendo vistas na rede. Um relatório recente da Bloomberg, usando dados da Whisker Labs e da DC Byte, descobriu que enormes cargas de trabalho de IA estão levando a "harmônicos ruins" na rede.
O relatório descreve harmônicos ruins como uma distorção causada pelo uso maciço de energia - comparando-os com a estática que pode ser ouvida quando o volume de um alto-falante está muito alto. O resultado não é uma gradação suave de uso de energia, mas com aumentos e quedas rápidos, o que, de acordo com a Bloomberg, na verdade, está impactando as residências próximas. "Quanto pior a qualidade da energia, mais o risco aumenta", diz o relatório. "Picos repentinos ou quedas no fornecimento elétrico podem levar a faíscas e até incêndios domésticos".
De acordo com a Bloomberg, mais da metade das residências rastreadas pela qualidade da energia que mostram as piores distorções da qualidade da energia estavam a menos de 20 milhas de "atividade significativa do data center".
Essa atividade pode se referir a uma instalação de hiperescala ou a um cluster de data centers em uma área.
Falando à Bloomberg, a Dominion Energy - que atende a Virgínia do Norte, entre outras regiões, disse que não notou os mesmos níveis de distorção que os dados da Whisker Labs mostraram, mas que "em alguns casos raros, observamos períodos muito breves de interrupção harmônica acima do normal devido a configurações anormais ou problemas de equipamento quando uma nova instalação entra em operação pela primeira vez".
O vice-presidente de grandes conversores de energia da Vertiv, Giovanni Zanei, admitiu que era um problema de escala. "Alguns megawatts podem não ser um problema tão grande", diz ele. "Um data center de 100 MW é certamente uma história diferente".
Embora existam algumas implementações menores de IA, a tendência em todo o setor é que clusters maciços de GPU sejam implantados pelos hiperescalas e grandes empresas de tecnologia.
Em outubro de 2024, a Tesla disse que lançaria um cluster de 50.000 GPUs no Texas e planejou um cluster de 300.000 GPUs Nvidia Blackwell B200 para o verão de 2025. A empresa de IA de Elon Musk, xAI, tem um cluster de 200.000 GPUs apelidado de Colossus, que afirma que será expandido para um milhão de chips.
Enquanto isso, a Oracle oferece um "supercluster" composto por mais de 65.000 GPUs e lançou recentemente um supercluster "zettascale" com cerca de 131.072 GPUs Blackwell. Empresas como Meta, Amazon Web Services, Google e Microsoft também compraram GPUs não por um punhado, mas por um caminhão.
O consumo de energia de GPUs individuais é cada vez maior, com a linha Blackwell vendo a GPU B200 consumir até 1.200 W, enquanto a GB200 - com duas GPUs B200 emparelhadas com uma CPU Grace - pode chegar a 2.700 W.
The Critical Power Supplement
The changing face of the power grid
Energizando
Quando se trata da rápida ativação de grandes quantidades de GPUs, a Ansett da i3 está vendo os clientes recorrendo às baterias para "armazenar" a carga de TI, observando: "As baterias fazem o trabalho pesado durante o curto prazo, mas essa carga pode ser transferida para as concessionárias".
Zanei, da Vertiv, no entanto, não postula as baterias como uma solução ideal para esse problema, observando que dentro do rápido aumento do consumo de energia está a questão sutil da queda de tensão, ou queda.
O fornecedor tem realizado testes sobre a questão da queda de tensão, usando seus sistemas de fonte de alimentação ininterrupta (UPS) de 1 MW. "Testamos isso para ver a escala e a taxa em que isso está acontecendo, e pode ser facilmente de, digamos, talvez 30% ou 40% da carga, até 150% da carga, em questão de milissegundos, depois permanece lá por talvez 10, 20 milissegundos e volta para baixo", diz Zanei.
Isso complica ainda mais a questão. Não apenas uma demanda repentina e enorme de energia está sendo enviada ao fornecedor de serviços públicos, mas em menos de um segundo ela pode desaparecer e depois voltar. É a definição de "sinais mistos".
Segundo Zanei, o problema não se limita ao fornecedor de serviços públicos. Esse espasmo é ruim, independentemente da fonte de energia.
"Sempre que um data center precisa funcionar com geradores, os geradores não vão gostar disso [queda de tensão]", diz ele. "Ou, no caso em que um data center está funcionando com energia primária, mas não da concessionária - por exemplo, turbinas a gás. Novamente, as turbinas a gás não vão gostar, e você precisaria potencialmente superdimensionar massivamente as turbinas para evitar um problema”.
Depois, há baterias. Zanei diz: "As baterias são destinadas ao backup, no qual normalmente são usadas de vez em quando. Mas eles não são projetados para esse tipo de frequência - pode ser centenas ou milhares de vezes por dia”.
"Mesmo baterias com um tempo de ciclo mais alto não são feitas para isso, e uma garantia certamente não estaria disponível." Zanei acrescenta que, se fosse estimar, esperaria tal tributação”.
As cargas de trabalho podem reduzir pela metade a vida útil da bateria. Zanei observa que ter inteligência dentro do UPS para armazenar em buffer ou pelo menos suavizar algumas das flutuações de energia é algo que a Vertiv está vendo os clientes fazerem.
A Vertiv também está aconselhando os clientes sobre o uso de no-breaks e baterias para queda de tensão - em relação a questões de tamanho necessário, tipo de recipiente e se ter baterias e sistemas de no-break separados para o data center e esse propósito exato seria a melhor solução.
Alternativamente, os ultracapacitores podem ser a resposta de longo prazo, diz Zanei. "O ultracapacitor é um tipo de solução de armazenamento de energia e é muito bom para mover a energia para dentro e para fora", explica ele. "Ele armazena menos energia [do que uma bateria], mas é excelente para andar de bicicleta muito rapidamente e pode fornecer a energia necessária apenas para aqueles milissegundos, ou qualquer que seja o breve pico, e depois recarregar durante os vales".
A Schneider Electric, por outro lado, incorporou recursos de suavização de energia em seu UPS.
Mustafa Demirkol, vice-presidente de sistemas de data center da Schneider Electric, diz ao DCD que as soluções de buffer de energia já estão "incorporadas à nossa topologia", acrescentando: "Fomos projetados para isso antes que as flutuações de IA surgissem, porque também as víamos em outras aplicações".
"Quando você olha para as flutuações de carga da IA, você precisa olhar para isso de forma holística. E não se trata apenas de UPS, trata-se de começar no nível do servidor. Você pode precisar usar alguns buffs e recursos. Seu no-break precisa ser robusto o suficiente para lidar com esses tipos de estresse e flutuações de carga e, ao mesmo tempo, você precisa olhar para todo esse sistema, não apenas para o no-break, mas também para o seu comutador. Tudo precisa ser capaz de lidar com esse tipo de orçamento".
Soluções no chip
Zanei, da Vertiv, diz que sua equipe está em conversas regulares com empresas de chips. "Quando falo com os fabricantes de chip, fica claro que é uma questão de garantir que as GPUs, ou os servidores em geral, estejam no nível máximo. Eles precisam executar suas GPUs e o próprio data center dessa maneira. E a forma como a carga é puxada - a energia consumida por seus servidores é bastante síncrona”.
A DCD entrou em contato com vários fabricantes de GPU para obter informações sobre como eles poderiam projetar seus chips para evitar isso e se estão se esforçando para resolver o problema. Nenhum estava disposto a comentar o assunto.
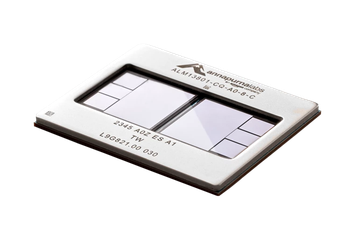
Apesar disso, a AWS e a Annapurna Labs fizeram alguns movimentos com a segunda geração de seu acelerador de IA desenvolvido internamente - Trainium. Esses chips diferem das GPUs tanto do ponto de vista arquitetônico quanto de seus recursos finais.
"Se você olhar para a arquitetura da GPU, são milhares de pequenos núcleos tensores, pequenas CPUs que estão sendo executadas em paralelo. Aqui, a arquitetura é chamada de matriz sistólica, que é uma arquitetura completamente diferente", diz Gadi Hutt, diretor de engenharia de produtos e clientes da Annapurna Labs. "Basicamente, os dados fluem através da lógica da matriz sistólica que então faz a aceleração eficiente da álgebra linear".
Uma abordagem semelhante foi adotada por outros designers de chips, como a Furiosa AI.
O Trainium foi projetado para cargas de trabalho de treinamento de IA e não possui os recursos de computação de uso mais geral vistos nas GPUs. "Ele não pode fazer gráficos ou previsão do tempo, ou todo tipo de coisa que as GPUs podem fazer muito bem", diz Hutt. "Mas esses chips são projetados para fazer álgebra linear, acelerar álgebra linear e ritmo de alta utilização."
Peter DeSantis, vice-presidente sênior de computação utilitária da AWS, discutiu durante sua palestra no AWS Re:Invent 2024 intitulada a complexidade das leis de escalabilidade de IA: a física por trás da maximização do potencial de GPUs - ou outros aceleradores - para cargas de trabalho de IA.
Citando um artigo de 2020: Leis de dimensionamento para modelos de linguagem neural, DeSantis descreveu as cargas de trabalho de IA como "escalonamento", não "escalonamento". As leis de dimensionamento levantaram a hipótese de que os recursos do modelo melhoram à medida que você aumenta a escala de vários fatores, incluindo o número de parâmetros, o conjunto de dados, o tamanho e a quantidade de computação.
Como resultado, houve um impulso consistente e atencioso em direção a modelos maiores e mais intensivos em computação que de fato se tornaram mais capazes, com o objetivo de trazer o máximo de computação e memória de alta velocidade para o menor espaço possível, conectados com conectividade de baixa latência.
O "menor espaço possível" é talvez o elemento fundamental.
Espaços menores significam mais próximos, portanto, com cabos mais curtos e conexões de menor latência - como explica DeSantis: "Se você tem coisas mais próximas, pode usar fios mais curtos para transmitir dados entre eles, o que significa que você pode incluir mais fios. Isso também significa que você tem menor latência e pode usar protocolos mais eficientes para trocar dados. Portanto, isso parece bastante simples, mas é um desafio muito interessante".
Os próprios chips da AWS também exigem muita energia e, com isso, vem o problema da queda de tensão. Uma das maneiras pelas quais o chip Trainium2 foi ajustado para evitar isso é através do uso de fios relativamente "grandes" - vias de energia - que permitem que eles movam energia em baixas tensões.
"Um semicondutor usa a presença ou ausência de pequenas cargas elétricas para armazenar e processar informações. Portanto, quando os chips encontram quedas ou quedas de tensão, eles normalmente precisam esperar até que o sistema de fornecimento de energia se ajuste, e esperar não é algo que você queira fazer com um chip", diz DeSantis.
Na verdade, é muito mais eficiente mover energia em tensões mais altas em um data center, de modo que a energia é progressivamente reduzida à medida que se aproxima dos chips - cujo estágio final é antes de entrar no pacote.
De acordo com DeSantis, isso normalmente é feito por meio de reguladores de tensão posicionados o mais próximo possível da embalagem. Em um esforço para reduzir a queda de tensão quando comparado ao chip Trainium1, o Annapurna Labs trouxe os reguladores de tensão ainda mais perto do chip - na verdade, sob o perímetro do pacote.
"Fazer isso é bastante desafiador, porque os geradores de tensão geram calor e, portanto, você precisa fazer uma engenharia inovadora. Mas, ao mover esses reguladores de tensão para mais perto do chip, podemos usar fios mais curtos, e fios mais curtos significam menos queda de tensão.
A AWS pode ter conseguido resolver esse problema em um nível de chip para seus chips Trainium2, mas, em última análise, o próprio design das GPUs torna irreal que veremos uma resolução em nível de chip sem que elas revolucionem fundamentalmente sua abordagem.
E, na maioria das vezes, essa não será a prioridade. Sim, eles têm "spikiness" embutido, mas as GPUs também são incrivelmente poderosas e populares. O incentivo para reinventar é limitado.
Enquanto isso, os operadores de data center terão que recorrer ao seu UPS na esperança de suavizar o perfil de energia das cargas de trabalho de treinamento de IA.
Se não o fizerem, as consequências para a rede podem ser graves. Os operadores de data center também podem ter problemas.
Como Demirkol, da Schneider Electric, aponta: "Provavelmente haverá falhas no nível upstream e você poderá até danificar suas GPUs".



Comments