
El crecimiento explosivo de la inteligencia artificial ha generado un volumen de datos sin precedentes, el cual pone a prueba la capacidad de las infraestructuras de almacenamiento en toda la región. El 30 de septiembre, durante el evento DCD>Compute Latam, profundizaremos en esta temática en el panel "Almacenamiento en tiempos de IA: ¿Podemos hacer frente a la sobrecarga de datos generados por la inteligencia artificial?". El evento, co-located con DCD>Connect Latam, se llevará a cabo en el Barceló Maya Grand Resort.
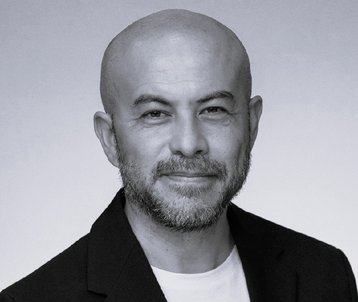
Participan en el panel: Rodrigo Olivares, Regional Senior Manager - Data, AI & Analytics en Nissan Motor Corporation; Jorge Ulises González Medina, Director of Data, AI & Advanced Analytics en Actinver; Héctor Aguilar, CTO de Grupo Fórmula; Rodrigo Rodríguez, Senior Cloud Solution Architect & AI en Microsoft; Diana Hidalgo, IT Digital Lead en Johnson & Johnson; y Yascara Caballero, Regional D&IT Business Solutions Manager en Japan Tobacco International.
DCD entrevistó a Héctor Aguilar antes de su participación en el panel.
La inteligencia artificial genera cantidades de datos sin precedentes. ¿Cuál consideran que es hoy el mayor reto: almacenar, procesar o extraer valor de esos datos?
Hoy en día, almacenar y procesar datos ya no representa el mayor obstáculo, porque existen tecnologías accesibles y eficientes para hacerlo. El verdadero reto está en extraer valor de esos datos, es decir, convertirlos en decisiones que impacten directamente en el negocio. Aunque las organizaciones tienen acceso a enormes volúmenes de información, muchas veces carecen de casos de uso claros, métricas que definan la ruta y el éxito de las decisiones. Además, la calidad y la coherencia de los datos son un problema constante: sin reglas comunes ni procesos de limpieza, los modelos terminan aprendiendo de datos basura o inservibles en lugar de conocimiento útil.
A esto se suman otros desafíos, como llevar ese conocimiento a la operación diaria en el momento oportuno, cumplir con regulaciones de privacidad y derechos de autor, y formar equipos con la cultura y las habilidades necesarias para aprovechar la información. En este sentido, el factor clave ya no es solo la cantidad de datos que se tiene, sino la capacidad de transformarlos en decisiones más rápidas, seguras y con resultados tangibles para la organización.
¿Cómo se equilibra la necesidad de innovación en IA con las limitaciones de costos y capacidad de infraestructura de almacenamiento?
Equilibrar la innovación en IA con costos e infraestructura es un reto estratégico. Por un lado, las organizaciones necesitan experimentar, probar modelos y generar nuevos productos; pero al mismo tiempo deben cuidar que el almacenamiento, el cómputo y el ancho de banda no disparen el gasto. La clave está en definir prioridades claras: no todo dato debe guardarse ni todo modelo necesita entrenarse desde cero. Optar por enfoques como el data tiering (diferenciar datos críticos de los históricos), el uso de modelos preentrenados y la adopción de servicios bajo demanda ayuda a contener costos sin frenar la innovación.
Además, es importante ver la infraestructura como una inversión escalable y no como un gasto fijo. Estrategias como aprovechar la nube híbrida, el cómputo en la periferia (edge) o incluso tecnologías de compresión y formatos abiertos permiten crecer de manera gradual según el valor que generen los casos de uso. De esta forma, la innovación en IA no se convierte en un lujo, sino en un proceso sostenible, donde cada inversión en almacenamiento y procesamiento se traduce en beneficios medibles para el negocio.
¿Qué papel juega la nube frente a las soluciones on-premise en este nuevo escenario de datos masivos?
La nube juega un papel fundamental porque ofrece escalabilidad y flexibilidad inmediata: es elástica y se paga por uso, lo que significa que permite crecer o reducir capacidad de almacenamiento y cómputo según la demanda, algo clave en escenarios donde los volúmenes de datos son impredecibles. Además, facilita el acceso a servicios avanzados de inteligencia artificial ya listos para usar, lo que reduce tiempos de innovación. Sin embargo, la nube también implica costos variables que, si no se gestionan con disciplina, pueden volverse difíciles de controlar.
Por su parte, las soluciones on-premise siguen siendo relevantes cuando se busca control, seguridad y optimización de costos a largo plazo, especialmente en organizaciones con datos sensibles o cargas de trabajo estables. En la práctica, lo que estamos viendo es un modelo híbrido: se aprovecha la nube para picos de procesamiento, desarrollo y escalado rápido, mientras que la infraestructura local se utiliza para operaciones críticas, almacenamiento de datos estratégicos y cumplimiento regulatorio. De esta combinación surge el equilibrio entre innovación y eficiencia en la era de los datos masivos.


Comments