
Amazon Web Services (AWS) ha detallado su supercúmulo de chips Trainium2 "Proyecto Rainier" en una publicación de blog.
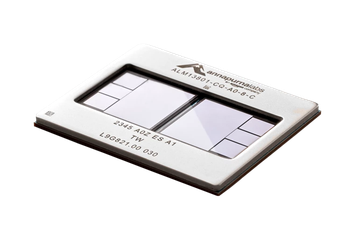
Anunciado por primera vez durante el evento Re:Invent en Las Vegas a fines del año pasado, el Proyecto Rainier se está desarrollando junto con la empresa de inteligencia artificial generativa Anthropic y será un clúster de Trainium2 UltraServers que contendrá "cientos de miles" de chips Trainium2 interconectados con redes EFA de escala petabit de baja latencia y tercera generación.
El clúster se distribuirá en varios centros de datos en EE. UU. y Anthropic lo utilizará para desarrollar e implementar futuras versiones de su modelo de IA, Claude. Solo se mencionó el nombre de una de las ubicaciones de los centros de datos (el condado de St. Joseph, Indiana).
AWS anunció sus planes para un campus en el condado de St. Joseph en abril de 2024, comprometiéndose a invertir 11.000 millones de dólares en el sitio y a iniciar las obras en octubre de 2024. Las imágenes sugieren que el campus podría contar con hasta 22 edificios.
La entrada del blog añade que los nuevos centros de datos que se están construyendo para el Proyecto Rainier (y más allá) incluirán varias mejoras en materia de eficiencia energética y sostenibilidad, y minimizarán el uso de agua.
“Rainier proporcionará cinco veces más potencia de cálculo que el clúster de entrenamiento más grande de Anthropic”, afirmó Gadi Hutt, director de ingeniería de producto y clientes de Annapurna Labs. “Para un modelo de vanguardia como Claude, cuanto más cómputo se invierta en su entrenamiento, más inteligente y preciso será. Estamos desarrollando potencia de cálculo a una escala sin precedentes, y lo hacemos con una velocidad y agilidad sin precedentes”.
El Proyecto Rainier se describe como un enorme "UltraCluster EC2 de UltraServers Trainium2". Los UltraServers, también lanzados por AWS el año pasado, cuentan con 64 chips Trainium2 y pueden ofrecer hasta 83,2 FP8 petaflops de potencia de cómputo. Son, en realidad, cuatro instancias combinadas en un solo nodo, comunicadas mediante conexiones de alta velocidad llamadas "NeuronLinks". Cada UltraServer se conecta mediante la tecnología de red Elastic Fabric Adaptor (EFA), tanto dentro como entre centros de datos.
La entrada del blog añade que «Cuando conectas decenas de miles de estos UltraServers y los diriges al mismo problema, obtienes el Proyecto Rainier, un mega "UltraCluster".
No está claro el número exacto de UltraServers que se implementarán en el marco del Proyecto Rainier, pero AWS ya ha dicho anteriormente que en algún momento tendrá cientos de miles de chips Tranium2.
Los chips Trainium2 utilizan una arquitectura de matriz sistólica. Hutt declaró previamente a DCD que: « Básicamente, los datos fluyen a través de la lógica de la matriz sistólica, que luego realiza la aceleración eficiente del álgebra lineal», explicando que los chips no son capaces de gestionar la misma variedad de problemas que las GPU: «Estos chips están diseñados para procesar álgebra lineal, acelerar el álgebra lineal y mantener el ritmo en condiciones de alta utilización».
Oracle Cloud Infrastructure también ha estado construyendo lo que llama “superclusters”, aunque utilizando hardware de terceros.
A principios de este mes, Oracle anunció planes para un clúster de IA con hasta 131.072 de las nuevas GPU MI355X de AMD.
La compañía también cuenta con un superclúster Nvidia GB200 NVL72 OCI con 131.072 GPU Blackwell y superclústeres de las GPU H100 y H200.

Comments