
Nvidia sigue creciendo.
A finales del año pasado, el gigante tecnológico se hizo con la startup de chips Groq en una compleja operación de 20 000 millones de dólares. No se trató de una adquisición —una molesta formalidad que conlleva la supervisión de las autoridades reguladoras—, sino más bien de una contratación casi total de la plantilla y la obtención de licencias tecnológicas.
Este artículo apareció originalmente en el suplemento «AI Hardware». Léelo gratis hoy mismo.
«Fue realmente rápido», explica a DCD Ian Buck, vicepresidente y director general de hiperescala y HPC de Nvidia, sobre la operación, anunciada en Nochebuena de 2025. El director ejecutivo de Groq, Jonathan Ross, «recibió su portátil de Nvidia el día de Navidad; celebré una reunión de lanzamiento el día 27 y, desde entonces, todo ha sido increíble».
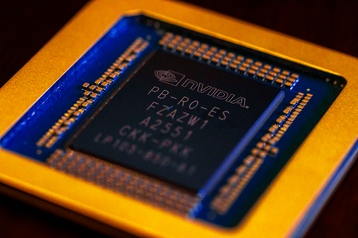
Este ritmo acelerado ha continuado: en marzo, Nvidia anunció que lanzaría chips basados en Groq antes de que acabara el año, junto con nuevas GPU y CPU, y que iría sacando más chips Groq con periodicidad anual.
La rapidez con la que se ha cerrado el acuerdo ha llamado la atención, y algunos lo ven como una medida desesperada por parte de una fuerza dominante que busca mantener su control sobre el mercado de la computación de IA. Nvidia ha visto cómo su capitalización bursátil se disparaba con el argumento de que la GPU es el chip definitivo para todo lo relacionado con la computación acelerada; ahora ha lanzado una alternativa —y ha tenido que buscarla fuera de la empresa para encontrarla.
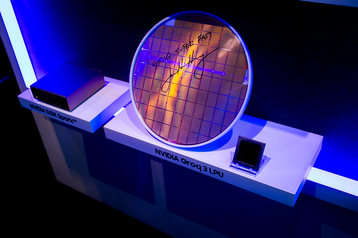
Buck tiene una respuesta singular. «En el 75 % de los casos de uso, este chip aportará muy poco o ningún valor», afirma, mostrando un Groq 3, la versión de la empresa del hardware de Groq. La unidad de procesamiento del lenguaje (LPU) está pensada para la inferencia de IA ultrarrápida y de baja latencia en la era de la IA agentiva.
La clave de su velocidad es la memoria de acceso aleatorio estático (SRAM). «La SRAM es el tipo de memoria más cara», explica Buck. «Pero es extremadamente rápida. Es siete veces más rápida que la HBM, que es la tecnología de memoria más rápida, aparte de la SRAM, que utilizamos», y la que se emplea en sus GPU.
Mientras que la HBM se encuentra junto a las GPU, la SRAM está integrada en el propio chip, lo que significa que los datos no tienen que desplazarse de un lado a otro.
Sin embargo, el reto con la LPU es que la cantidad de SRAM es relativamente pequeña, de 500 MB. Incluso cuando se combinan 256 LPU en un único rack, eso supone 128 GB de SRAM integrada en el chip, una cifra inferior a los 288 GB de HBM4 que hay en un solo Vera Rubin.
Aquí es donde la empresa Groq tuvo dificultades, pero la tecnología Groq brillará, argumenta Nvidia. En lugar de esperar que la LPU compita, la empresa la tratará como un complemento de la GPU, desagregando los cálculos y derivando las partes adecuadas de la carga de trabajo al chip adecuado.
La empresa solo ofrecerá el hardware a gran escala, con los 256 chips combinados en un rack Nvidia Groq 3 LPX. Cada bandeja del rack albergará ocho LPU Groq 3. Está previsto que se comercialice junto con un rack Vera Rubin NVL72, de modo que las partes de la decodificación que requieren mayor potencia de cálculo y son más complejas se realicen en las GPU, mientras que el trabajo que exige una latencia extremadamente baja se derivará a las LPU.
Tomando como ejemplo un chatbot, Buck explica: «Cuando empiezas a agrupar tu contexto, todo lo que has dicho anteriormente en el chat tiene que introducirse y procesarse junto con el modelo. Ese fue uno de los mayores retos para las LPU [de la época de la empresa Groq], porque no podían albergar toda esa memoria de contexto para los lotes completos que estaban procesando. Pero podemos realizar todo ese procesamiento aquí», afirma, mostrando una Rubin, «gracias a la memoria HBM».
La HBM y la GPU se encargan de «todas las funciones softmax y todo lo relacionado con el enrutamiento. No tenemos que enviar ningún cálculo clave-valor a la LPU. La LPU puede centrarse únicamente en los pesos. Sí que tenemos que almacenar todos los pesos allí, pero solo una copia».
La división de la carga de trabajo «no es una desagregación tradicional en la que los tokens de entrada se procesan en la GPU y la decodificación la realizan unos ASIC», argumenta Buck. «En realidad, estamos fusionando todo el proceso, y para ello aprovechamos el software en el que hemos invertido con Dynamo, y en el que ellos han estado invirtiendo en Groq, de modo que podemos mover rápidamente los tokens entre los dos procesadores».
El director ejecutivo y fundador, Jensen Huang, ofreció una explicación más concisa durante una breve conversación: «Para el consumo principal de tokens, Vera Rubin es imbatible. Groq no cambiará eso. Sin embargo, creemos que está surgiendo un nuevo segmento en el que los modelos deben ser a la vez grandes, el contexto amplio y la latencia extremadamente corta.
«Groq puede cumplir una de esas tres promesas, pero no las tres. Sin embargo, combinando Vera Rubin y Groq, podemos cumplir las tres promesas, de modo que podamos crear este nuevo segmento: modelos grandes, contexto amplio y tokens ultrarrápidos».
La visión optimista de Huang corre el riesgo de ocultar un mensaje más amplio detrás de sus comentarios: las GPU siguen siendo la columna vertebral del auge de la IA, pero se admite que existe un espacio en los extremos del espectro de cargas de trabajo para chips alternativos, aunque complementarios.
Otras empresas de chips de inferencia basados en SRAM, desde d-Matrix hasta Cerebras, se han hecho eco de la noticia, alegando que valida su enfoque —que a menudo no incluye el margen de beneficio de Nvidia—.
La LPU Groq 3 es, en muchos sentidos, un chip desarrollado por otra empresa. Este lanzamiento inicial lleva el sello de una integración rápida, con una mezcla de tecnología de Nvidia, licencias de Groq y hardware de terceros.
«Obviamente, estaban trabajando en la versión 2 del chip de Groq», afirma Buck. «Fuimos capaces de acelerar el desarrollo de la versión 2 hasta convertirla en la versión 3 en nuestras manos. Desde el punto de vista del silicio, obviamente, es muy similar a lo que ya tenían, pero lo que no tenían era un factor de forma compacto con una solución de refrigeración líquida».
La LPU se irá «nvidianizando» poco a poco, con la llegada de la LPU 35 el año que viene y la LPU 40 prevista junto con la línea de GPU Feynman. Este último chip abandonará la interconexión personalizada de Groq en favor del popular NV Link de Nvidia y añadirá compatibilidad con NVFP4.
La CPU que integra la LPX de primera generación ni siquiera procede de Nvidia; aunque la empresa se ha negado a revelar los detalles del hardware, los racks que ha podido ver DCD parecen incluir chips AMD Epyc.
Es probable que, en algún momento, Nvidia cambie a su propia línea de CPU, que se actualizará este año con la CPU Vera.
Al igual que la LPU, está orientada a la era de los agentes.


«El futuro empieza a parecer un poco más “agentico”, en el que las IA se comunican entre sí», afirma Buck. «Los modelos de lenguaje grande (LLM) son IA que se comunican con humanos; simplemente hemos eliminado a los humanos del proceso, por lo que, básicamente, la velocidad depende de lo rápido que este agente pueda comunicarse con aquel otro. No está limitado por la percepción humana».
Nvidia entró en el panorama de las CPU para centros de datos en 2023 con el chip Grace, basado en núcleos Arm Neoverse. El chip, anunciado por primera vez en 2021, fue anterior a la mayor parte del auge de la IA, por no hablar de la actual fiebre por los sistemas «agentes».
«Resulta que la carga de trabajo que hay que conectar a una GPU es, en esencia, muy similar a lo que necesitan los sistemas agenticos», afirma Buck. «Hay un procesamiento KV inicial, un procesamiento de datos y, por supuesto, se necesitan núcleos rápidos, porque no queríamos que estas GPU fueran lentas».
Se remite a la Ley de Amdahl, según la cual la velocidad máxima teórica de un sistema viene limitada por la parte de la tarea que no se puede paralelizar. Grace se desarrolló simplemente para garantizar que la GPU Blackwell alcanzara todo su potencial.
«Tenemos que asegurarnos de contar siempre con el rendimiento de un solo hilo de la CPU más rápido para mantener ocupada la GPU».
El director ejecutivo Huang añade: «La IA no tiene que ver con los núcleos, sino con el trabajo. Cuando tienes 50 000 millones de dólares en GPU ahí sin hacer nada, seguramente no vas a mantener esas GPU inactivas mientras 1 000 millones de dólares en CPU están haciendo su trabajo.
«Hay que completar el trabajo de las CPU lo más rápido posible, para que las GPU por valor de 50 000 millones de dólares nunca estén inactivas. Esto significa que nuestros [requisitos de CPU] son fundamentalmente diferentes. Y, como resultado, hemos creado unas CPU muy distintas».
Pero lo que ocurrió fue que los clientes empezaron a utilizar las CPU Grace para otras tareas, entre ellas como gestor de caché KV en memoria para toda la flota de computación. «Así, por ejemplo, en el caso de la inferencia, cuando llega una consulta, la memoria clave-valor se ha fragmentado entre varios nodos para que estos puedan programar qué GPU atenderá la siguiente consulta del modelo de lenguaje grande (LLM)», explica Buck. «Y luego, a medida que se actualiza, mantienen esa base de datos en tiempo real y combinan todas esas cachés clave-valor».
Meta fue la primera empresa en anunciar públicamente que utilizaba Grace tanto conectada a una GPU como de forma independiente, pero DCD tiene entendido que hay otras empresas que también están implementando CPU de Nvidia independientes.
Con la próxima Vera, Nvidia está apostando de forma más agresiva por este mercado. «Este es nuestro próximo negocio de miles de millones de dólares», afirma Buck.
«Ahora puedo dedicarme a tareas de agente en la CPU», afirma. «Por eso se está produciendo esta explosión en el mercado de las CPU».
A pesar de esta explosión, que ha contribuido a impulsar la cotización de Intel y AMD, Buck califica a las CPU de «mercado desatendido».
Añade: «Se volvió aburrido porque la gente se limitaba a fabricar otra CPU con más núcleos y se centraba en el coste por núcleo. Nunca se oye hablar de rendimiento. Siempre se oye hablar del coste por núcleo, del coste por núcleo. Como resultado, el diseño de esas CPU para centros de datos derivó hacia un punto en el que simplemente no se valoraba la mejora del rendimiento».
En el mundo de los ordenadores personales ocurrió lo contrario, donde toda la atención se centró en el rendimiento y en un número reducido de núcleos. «Por desgracia, esto no va a funcionar para los agentes, donde se necesitan muchos núcleos y se quiere que todos sean rápidos».
Vera cuenta con 88 núcleos, notablemente menos que muchos de sus rivales en el ámbito de los centros de datos. «Menos núcleos, pero los núcleos son más rápidos, y la estructura que conecta todos estos núcleos es mucho más sólida», replica Buck. «Tiene el triple de ancho de banda de memoria por núcleo que x86 y el doble de eficiencia energética».
Para finales de año, Nvidia espera lanzar Vera, junto con la nueva GPU Rubin y la LPU Groq.
«Éramos una empresa de GPU», recuerda Buck. «Luego adquirimos Mellanox y nos convertimos en una empresa de GPU más NV Switch, Spectrum, Quantum, CX y así sucesivamente. Y ahora también Bluefield, Grace y LPU.
«No se puede dar servicio a todo el mercado de la IA sin los siete chips y los cinco tipos diferentes de racks. El alcance se está ampliando, los modelos no dejan de crecer y todas las modalidades de IA siguen desarrollándose».
Huang también echó la vista atrás. «Empezamos con la Riva 128», afirma, pasando por alto convenientemente la NV1, menos exitosa, que la precedió. «Solo teníamos un producto; ahora contamos con los modelos 5050, 5060 y 5090, y disponemos de todo tipo de productos. No es diferente de lo que ocurrió con el iPhone en sus inicios; ahora hay muchísimas versiones diferentes del iPhone.
«Tenemos clientes con necesidades diferentes, rangos de precios distintos, etc. Por eso hemos ido ampliando nuestra oferta en todo este espectro».
Comments